搜索文档
概述
首先明确一点,大模型是没有记忆功能的,每次会话对于大模型来说都是独立的。
如何解决记忆问题
实现这个记忆功能,就需要 额外的模块 去保存我们和模型对话的上下文信息,然后在下一次请求时,把历史信息都输入给模型,让模型输出结果。
在 LangChain 中, 记忆(Memory) 就是专门负责“ 存储历史交互信息 ”的组件,核心作用是「 保存上下文 」和「 提供上下文 」,让LLM在每次响应时,都能“看到”之前的对话内容。
上下文工程(Context Engineering) 负责 “合理组织”这些记忆和任务信息 ,让LLM的响应更连贯、更贴合需求。这也是Agent能实现 复杂多轮交互 的核心基础。
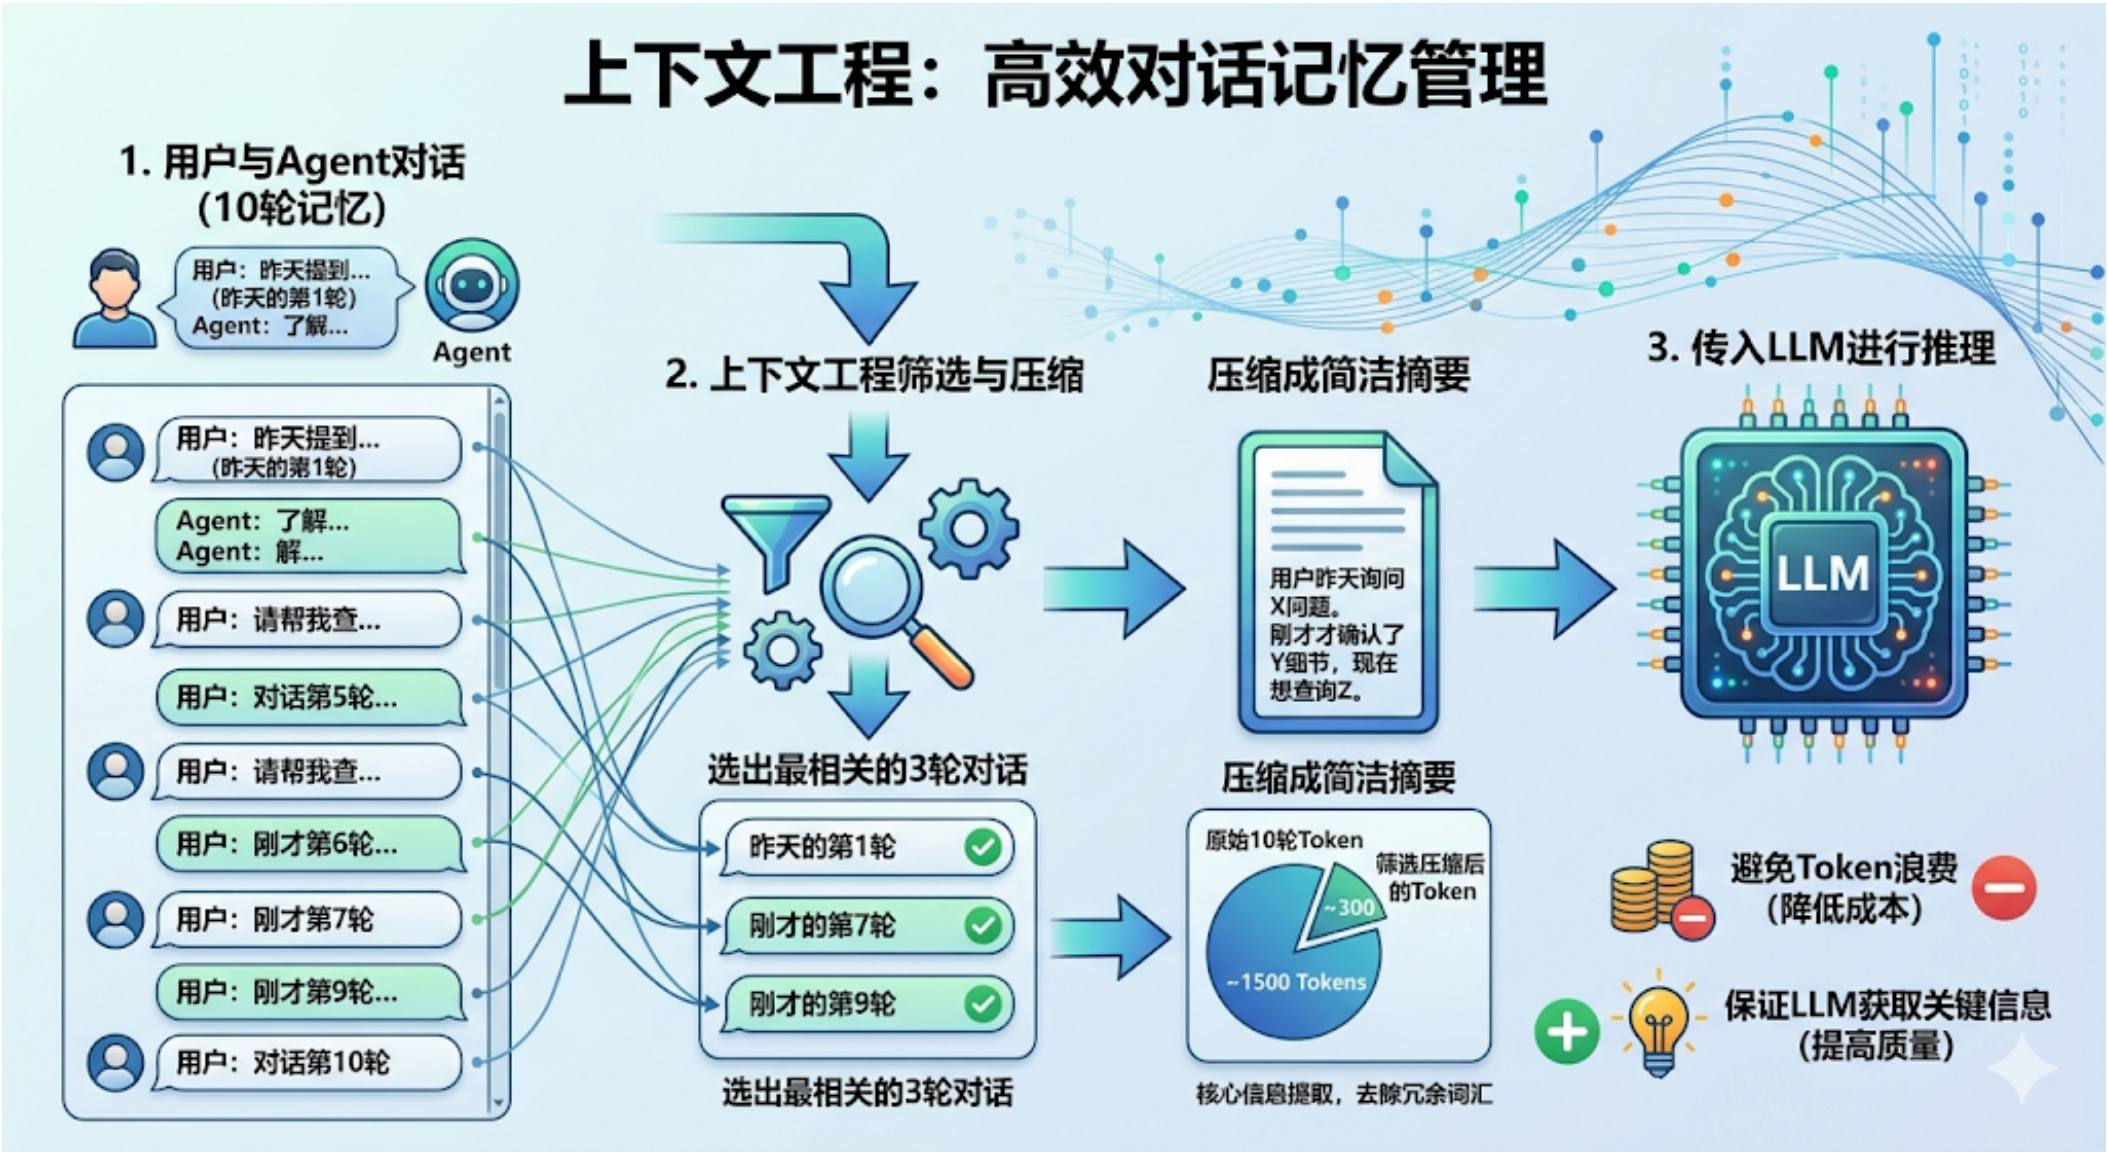
上下文类型及相关的API:
| 上下文类型 | 描述 | 生命周期 | 访问方法 |
|---|---|---|---|
| 动态运行时上下文 | 在单次运行中会演变的可变数据 | 单次运行 | LangGraph state对象 |
| 动态跨会话上下文 | 在对话间共享的持久数据。比如用户偏好、历史洞察、知识条目 | 跨会话 | LangGraph store对象 |
| 静态运行时上下文 | 在启动时传入的用户元数据、工具、数据库连接 | 单词运行 | LangGraph context对象 |
记忆的分类
- 短期记忆(Short-term memory、会话级记忆、thread-scoped memory):作用范围是单个对话线程(Thread)内,一旦开启新对话(更换 thread_id ),记忆即消失。
- 长期记忆(Long-term memory,跨会话级记忆 ):在会话间存储用户特定或应用级数据,并在会话线程间共享。它可以随时在任何线程中被调用。记忆的范围是任意自定义命名空间,而不仅仅是单一线程 ID。
短期记忆
基于内存
- 创建 Agent 时传入
checkpointer配置项,值为InMemorySaver()实例对象。 - 多次调用
invoke方法是传入config配置对象,通过config.configurable.thread_id保证所有会话在同一进程里。
python
import os
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver

load_dotenv(verbose=True)

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    checkpointer=InMemorySaver()
)

def run(user_input: str, thread_id: str = "1"):
    res = agent.invoke({"messages": [user_input]}, config = {
        "configurable": {
            "thread_id": thread_id
        }
    })
    print(res["messages"][-1].content)

print("第一次调用:")
run("你好,我是 iGma")

print("\n第二次调用:")
run("我叫什么名字?")

print("\n第三次调用:")
run("我叫什么名字?", "2")

""" 输出结果:
第一次调用:
你好,iGma!很高兴认识你。我是你的 AI 助手,有什么想聊的或需要帮忙的,随时告诉我。

第二次调用:
你叫 **iGma**。😊

第三次调用:
我不知道你的名字——目前对话里没有你的名字信息。你可以告诉我,我该怎么称呼你。
"""基于外部存储器 PostgreSQL
数据库配置
首先需要准备 PostgreSQL 环境,以 Mac 系统为例,通过 brew 安装 PostgreSQL。
bash
brew install postgresql验证安装(查看 PostgreSQL 版本`)
bash
psql --version启动服务
bash
brew services run postgresql查看启动状态
bash
brew services list

# 输出下面内容表示启动成功
# Name          Status  User File
# postgresql@18 started /opt/homebrew/opt/postgresql@18/xxx设置密码
bash
\password验证密码
bash
psql -U 你的用户名 -d postgres -W

# 执行后输入密码,密码输入正确会看到下面这个提示
# postgres=#数据库指令
sql
-- 创建数据库
CREATE DATABASE langchain_db;

-- 查看所有数据库
SELECT datname FROM pg_database;Python 代码
python
import os
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.postgres import PostgresSaver

load_dotenv(verbose=True)

DB_URL = "postgresql://igma:123123@localhost:5432/langchain_db?sslmode=disable"

with PostgresSaver.from_conn_string(DB_URL) as db:
    db.setup()

    agent = create_agent(
        model=init_chat_model(
            model="deepseek-flash",
            api_key=os.getenv("DEEPSEEK_API_KEY"),
            base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
        ),
        checkpointer=db
    )

    def run(user_input: str, thread_id: str = "1"):
        res = agent.invoke({"messages": [user_input]}, config = {
            "configurable": {
                "thread_id": thread_id
            }
        })
        print(res["messages"][-1].content)

    print("第一次调用:")
    run("你好,我是 iGma")

    print("\n第二次调用:")
    run("我叫什么名字?")

    print("\n第三次调用:")
    run("我叫什么名字?", "2")

""" 输出结果:
第一次调用:
你好,iGma!很高兴认识你。有什么我可以帮你的吗?

第二次调用:
你叫 **iGma**。

第三次调用:
我不知道你的名字。你还没有告诉我。可以告诉我你希望我怎么称呼你。
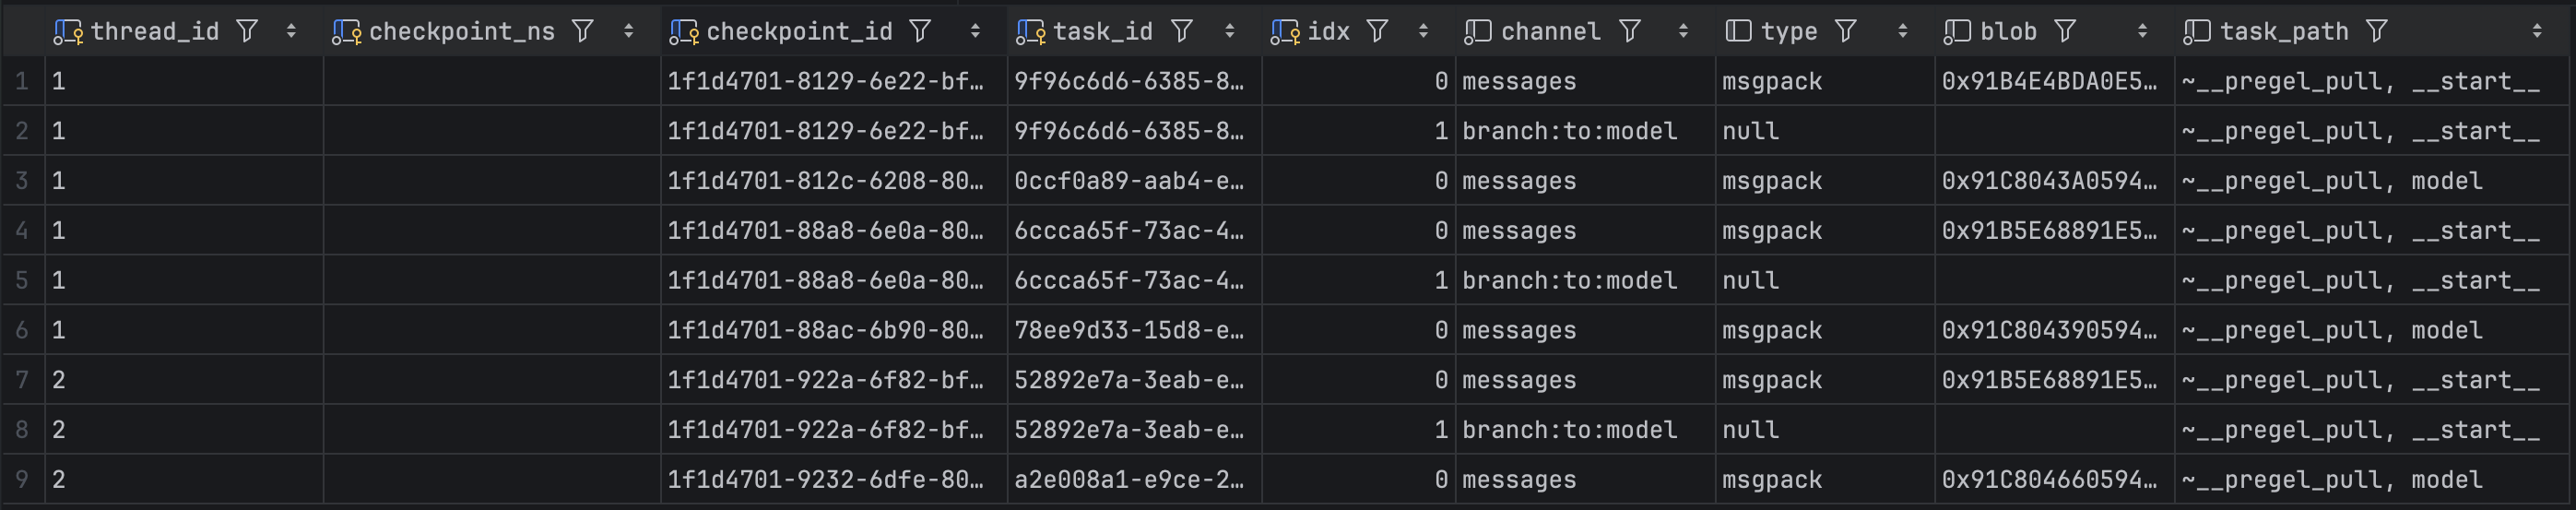
"""setup()用于初始化PostgreSQL数据库,首次运行会创建必要的表,重复执行不会重新建表,底层逻辑是Create IF Not Exists。- 执行上面代码会创建4张表:
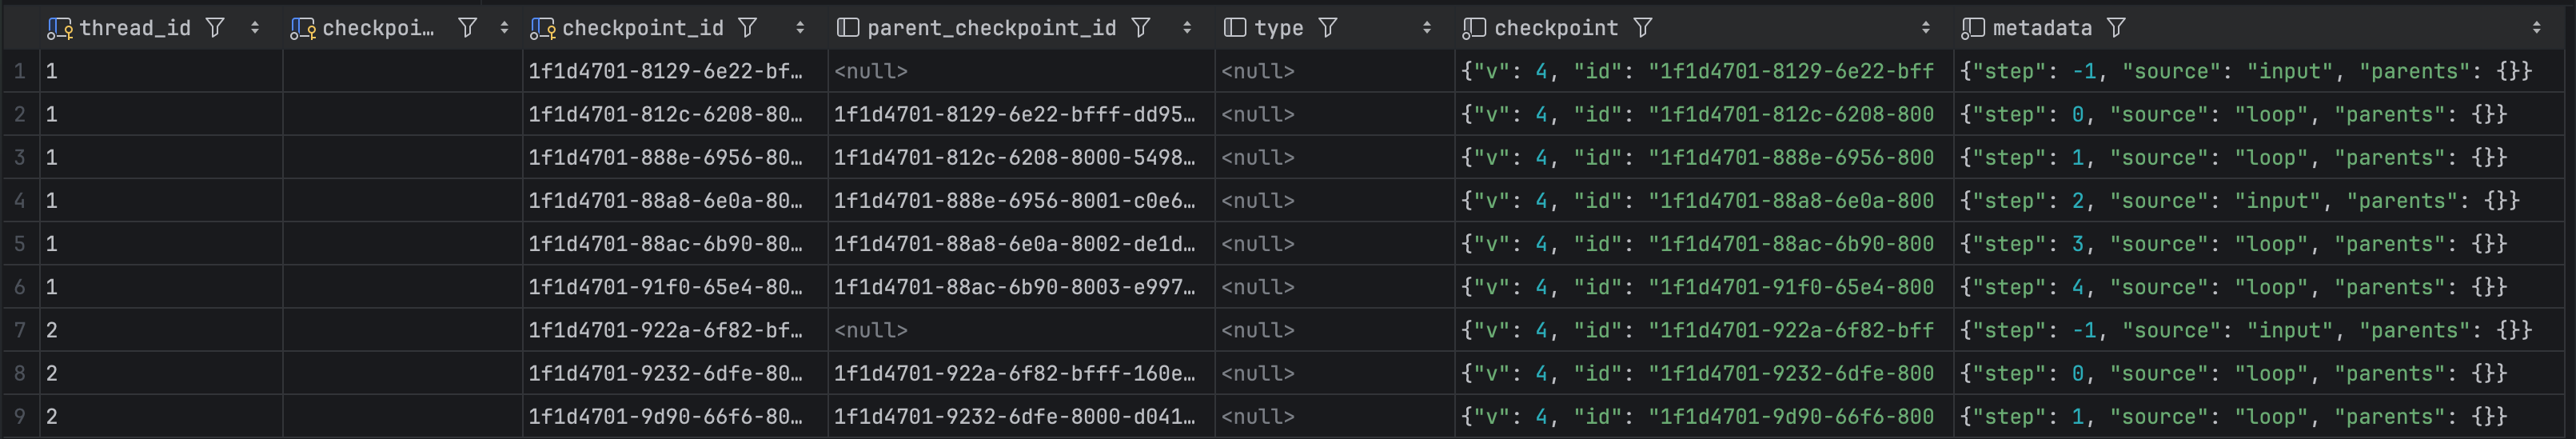
- checkpoints:核心检查点元数据表。这是主表,每次 Agent 运行一步(或一轮对话),就会在这里存入一条记录。它保存的是这次快照的“元信息”,比如 thread_id(区分是谁的对话)、checkpoint_id(这一步的唯一标识)、执行到了哪一步、下一步该执行什么节点等。简单说,它记录了“在什么时间、哪个对话、进行到了哪一步”。
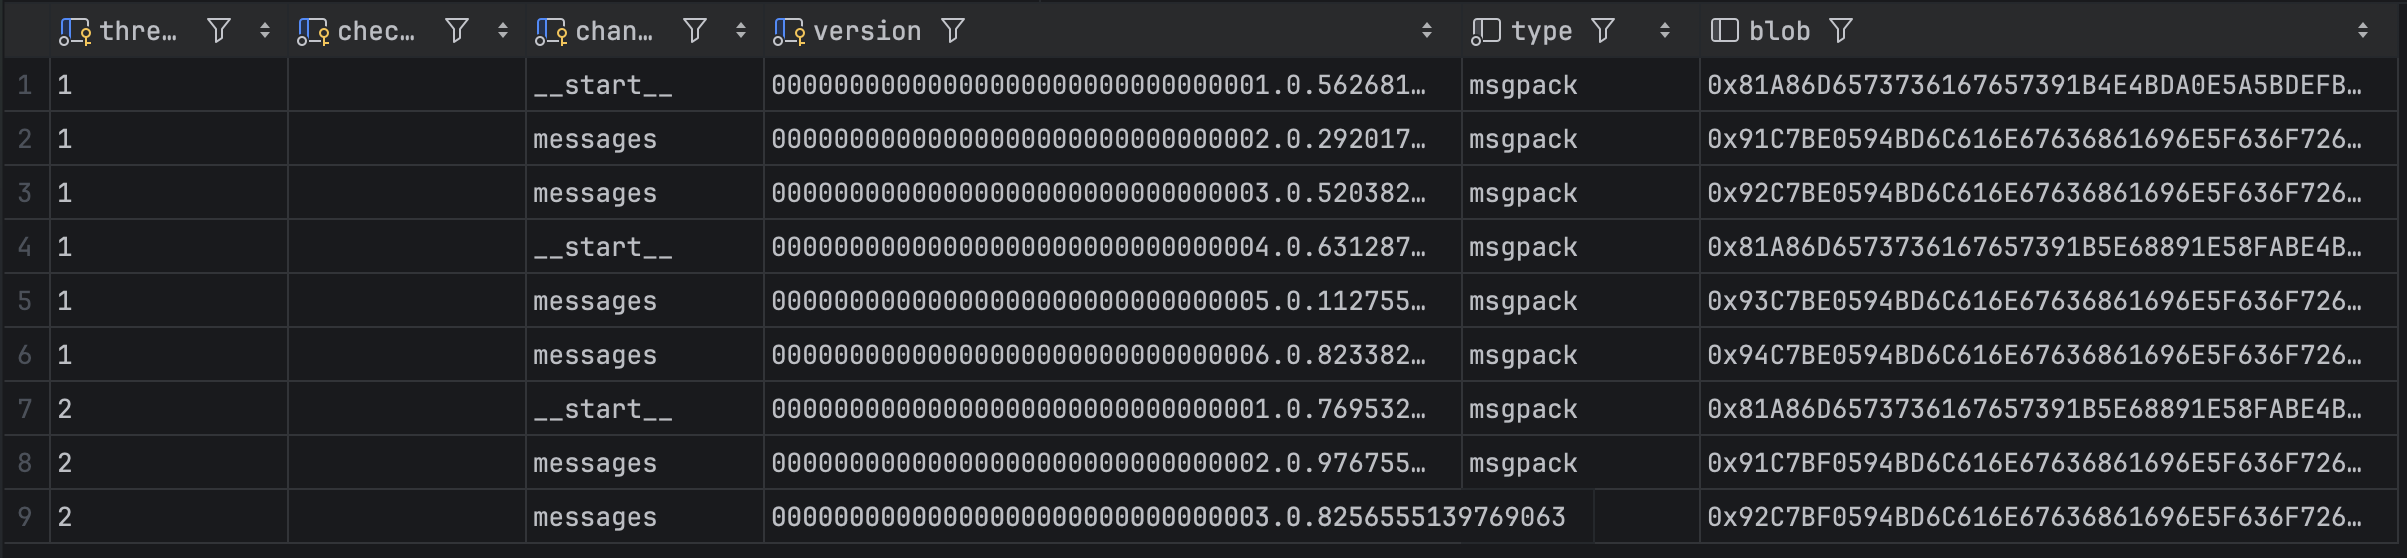
- checkpoint_blobs:实际状态数据存储表。checkpoints 表存的是元数据,而真正的对话内容(比如你之前说的话、AI 的回复、工具的返回结果)体积比较大,就存放在 checkpoint_blobs 里。它以 BYTEA(二进制)格式存储序列化后的状态值,按 thread_id 和通道(channel)来区分。简单说,它存的是“这一步的具体内容是什么”。
- checkpoint_writes:中间写入记录表。Agent 在执行一个复杂步骤时,可能会涉及多个节点的并行或中间状态。如果中途发生异常或需要人工干预(Human-in-the-loop),LangGraph 需要知道哪些节点的结果已经成功写入了。这张表就是用来记录这些“中间写入动作”的,确保恢复执行时不会重复运行已经成功的节点。
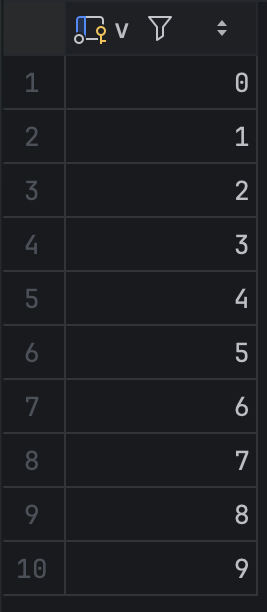
- checkpoint_migrations:数据库版本记录表。这张表只有一列 v(整数),用来记录当前数据库表结构已经应用到了哪个版本。setup() 方法每次运行时都会检查这张表,如果版本落后就自动执行相应的建表或改表语句,保证你的数据库结构始终和 LangGraph 库的版本匹配。
- checkpoints:核心检查点元数据表。这是主表,每次 Agent 运行一步(或一轮对话),就会在这里存入一条记录。它保存的是这次快照的“元信息”,比如 thread_id(区分是谁的对话)、checkpoint_id(这一步的唯一标识)、执行到了哪一步、下一步该执行什么节点等。简单说,它记录了“在什么时间、哪个对话、进行到了哪一步”。
两者区别
- 存到内存中的记忆内容会随着程序结束而清空。
- 存到库里的数据不会清空,只要
thread_id不变,会自动加载数据库里的历史数据。
记忆治理
为什么要治理记忆?
- LLM的上下文窗口是有限的,完整历史可能无法装入LLM的上下文窗口,导致上下文丟失或错误。
- 即便模型的上下文窗口够大,多数LLM在长上下文场景仍然表现不佳。模型会被陈旧或离题的内容“分散注意力” 。
- 会带来高昂的token花费。
消息裁剪
调用模型前裁剪上下文,目标是控制token用量,通常保留系统初始消息和最近若干消息,或按token数保留末尾内容。适合成本敏感、对旧上下文依赖不强的场景。
python
import os
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.agents.middleware import before_model
from langchain.chat_models import init_chat_model
from langchain_core.messages import RemoveMessage
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph.message import REMOVE_ALL_MESSAGES

load_dotenv(verbose=True)

@before_model
def message_cropping(state, runtime):
    # 只保留第一个问题
    msgs = state["messages"]
    res = msgs[:2] + [msgs[-1]] if len(msgs) > 2 else msgs

    return {
        "messages": [
            RemoveMessage(id=REMOVE_ALL_MESSAGES),
            *res
        ],
    }

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    checkpointer=InMemorySaver(),
    middleware=[message_cropping]
)

def run(user_input: str, type: str = ""):
    res = agent.invoke({"messages": [user_input]}, config = {
        "configurable": {
            "thread_id": "1"
        }
    })

    if type == "end":
        for msg in res["messages"]:
            msg.pretty_print()

run("你好,我是 iGma")
run("你是谁?")
run("你能做什么?", "end")

""" 输出结果:
================================ Human Message =================================

你好,我是 iGma
================================== Ai Message ==================================

你好,iGma!很高兴认识你。我是 AI 助手,有什么可以帮你的吗?
================================ Human Message =================================

你能做什么?
================================== Ai Message ==================================

你好,iGma!我能帮你做不少事情,比如:xxxx
"""消息删除
消息裁剪是模型调用前裁剪消息列表,控制模型可以看到的上下文范围。
消息删除是在模型调用后对消息列表的过滤。
python
import os
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.agents.middleware import after_model
from langchain.chat_models import init_chat_model
from langchain_core.messages import RemoveMessage
from langgraph.checkpoint.memory import InMemorySaver

load_dotenv(verbose=True)

@after_model
def message_remove(state, runtime):
    # 保证消息列表不超过 5 条数据
    msgs = state["messages"]
    if len(msgs) > 5:
        return {
            "messages": [RemoveMessage(id=msg.id) for msg in msgs[:len(msgs) - 5]],
        }

    return None

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    checkpointer=InMemorySaver(),
    middleware=[message_remove]
)

count = 1
def run(user_input: str):
    global count
    res = agent.invoke({"messages": [user_input]}, config = {
        "configurable": {
            "thread_id": "1"
        }
    })

    print(f"第{count}次执行后消息列表的长度:{len(res["messages"])}")
    count += 1

run("你好,我是 iGma")
run("你是谁?")
run("你能做什么?")
run("什么是 Agent?")

""" 输出结果:
第1次执行后消息列表的长度:2
第2次执行后消息列表的长度:4
第3次执行后消息列表的长度:5
第4次执行后消息列表的长度:5
"""摘要
通过 SummarizationMiddleware 中间件,把早期历史压缩成摘要,再替换原始消息。
python
import os
from dotenv import load_dotenv
from langchain.agents import create_agent
from langchain.agents.middleware import SummarizationMiddleware
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver

load_dotenv(verbose=True)

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    checkpointer=InMemorySaver(),
    middleware=[
        SummarizationMiddleware(
            model=init_chat_model(
                model="deepseek-flash",
                api_key=os.getenv("DEEPSEEK_API_KEY"),
                base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
            ),
            trigger=[
                ("tokens", 100),
            ],
            keep=("messages", 2),
            summary_prompt="对历史消息摘要,消息列表如下\n{messages}"
        )
    ]
)

count = 1
def run(user_input: str):
    global count
    res = agent.invoke({"messages": [user_input]}, config = {
        "configurable": {
            "thread_id": "1"
        }
    })
    print("\n\n", "^" * 30, f"第{count}次", "^" * 30)
    for msg in res["messages"]:
        msg.pretty_print()

    count += 1

run("你好,我是 iGma" + "这是一堆废话,不用理会" * 100)
run("你是谁?")

""" 输出结果:
 ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ 第1次 ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
================================ Human Message =================================

你好,我是 iGma这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会这是一堆废话,不用理会
================================== Ai Message ==================================

你好,iGma!那些废话我已忽略。请告诉我你需要什么帮助。


 ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ 第2次 ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
================================ Human Message =================================

Here is a summary of the conversation to date:

历史消息摘要:用户打招呼并自我介绍为 **iGma**;其余内容均为重复废话,无需处理。
================================== Ai Message ==================================

你好,iGma!那些废话我已忽略。请告诉我你需要什么帮助。
================================ Human Message =================================

你是谁?
================================== Ai Message ==================================

...
"""长期记忆
长期记忆记录的是用户特定或应用级别的数据,任何会话都可以随时访问。
基础概念
类型划分
- Semantic Memory(语义记忆):记录事实/用户偏好/概念(用户喜欢简洁回答、用户常用中文、某个公司属于哪个行业)。
- Episodic Memory(情景记忆):记录Agent过去执行的动作(过去某个任务是怎么成功的、某种用户输入下,怎样回答效果最好)。
- Procedural Memory(程序性记忆):规则/做事方法(Agent的系统提示词、Agent的工作流程、工具调用规则)。
存储结构
长期记忆的存储是 store -> namespace -> key -> value 的四层架构。
- store:store是由LangGraph提供的,常用实现类
InMemoryStore(存内存)、PostgresStore(存数据库)。 - namespace:命名空间,类型是
字符串元组。 - key:是该 namespace 下的唯一标识,单条记忆的唯一键,数据类型为
字符串。 - value:是存储的值,数据类型为
字典(dict[str, Any])。
基础 API
put 写入数据
入参除 namespace、key、value 外还包括:
- index:控制语义检索索引,可选值:
- None(默认选项):使用 store 初始化时配置的索引配置,如果初始化时没有指定索引策略,则 index 参数将会被忽略。
- False:不为该 item 建立语义索引。
- list[str]: 只对指定字段路径建索引。
- ttl: 可选,过期时间。
get 读取数据
参数:namespace、key、refresh_ttl(是否刷新当前item的ttl)
python
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

store.put(
    ("user", "01"),
    "info",
    {"username": "iGma", "age": 26}
)
print(store.get(("user", "01"), "info"))

""" 输出结果:
Item(namespace=['user', '01'], key='info', value={'username': 'iGma', 'age': 26}, created_at='2026-10-31T12:34:14.126353+00:00', updated_at='2026-10-31T12:34:14.126743+00:00')
"""python
from langgraph.store.postgres import PostgresStore

DB_URL = "postgresql://igma:123123@localhost:5432/langchain_db?sslmode=disable"

with PostgresStore.from_conn_string(DB_URL) as db:
    db.setup()
    db.put(
        ("user", "01"),
        "info",
        {"username": "iGma", "age": 26}
    )
    print(db.get(("user", "01"), "info"))

""" 输出结果:
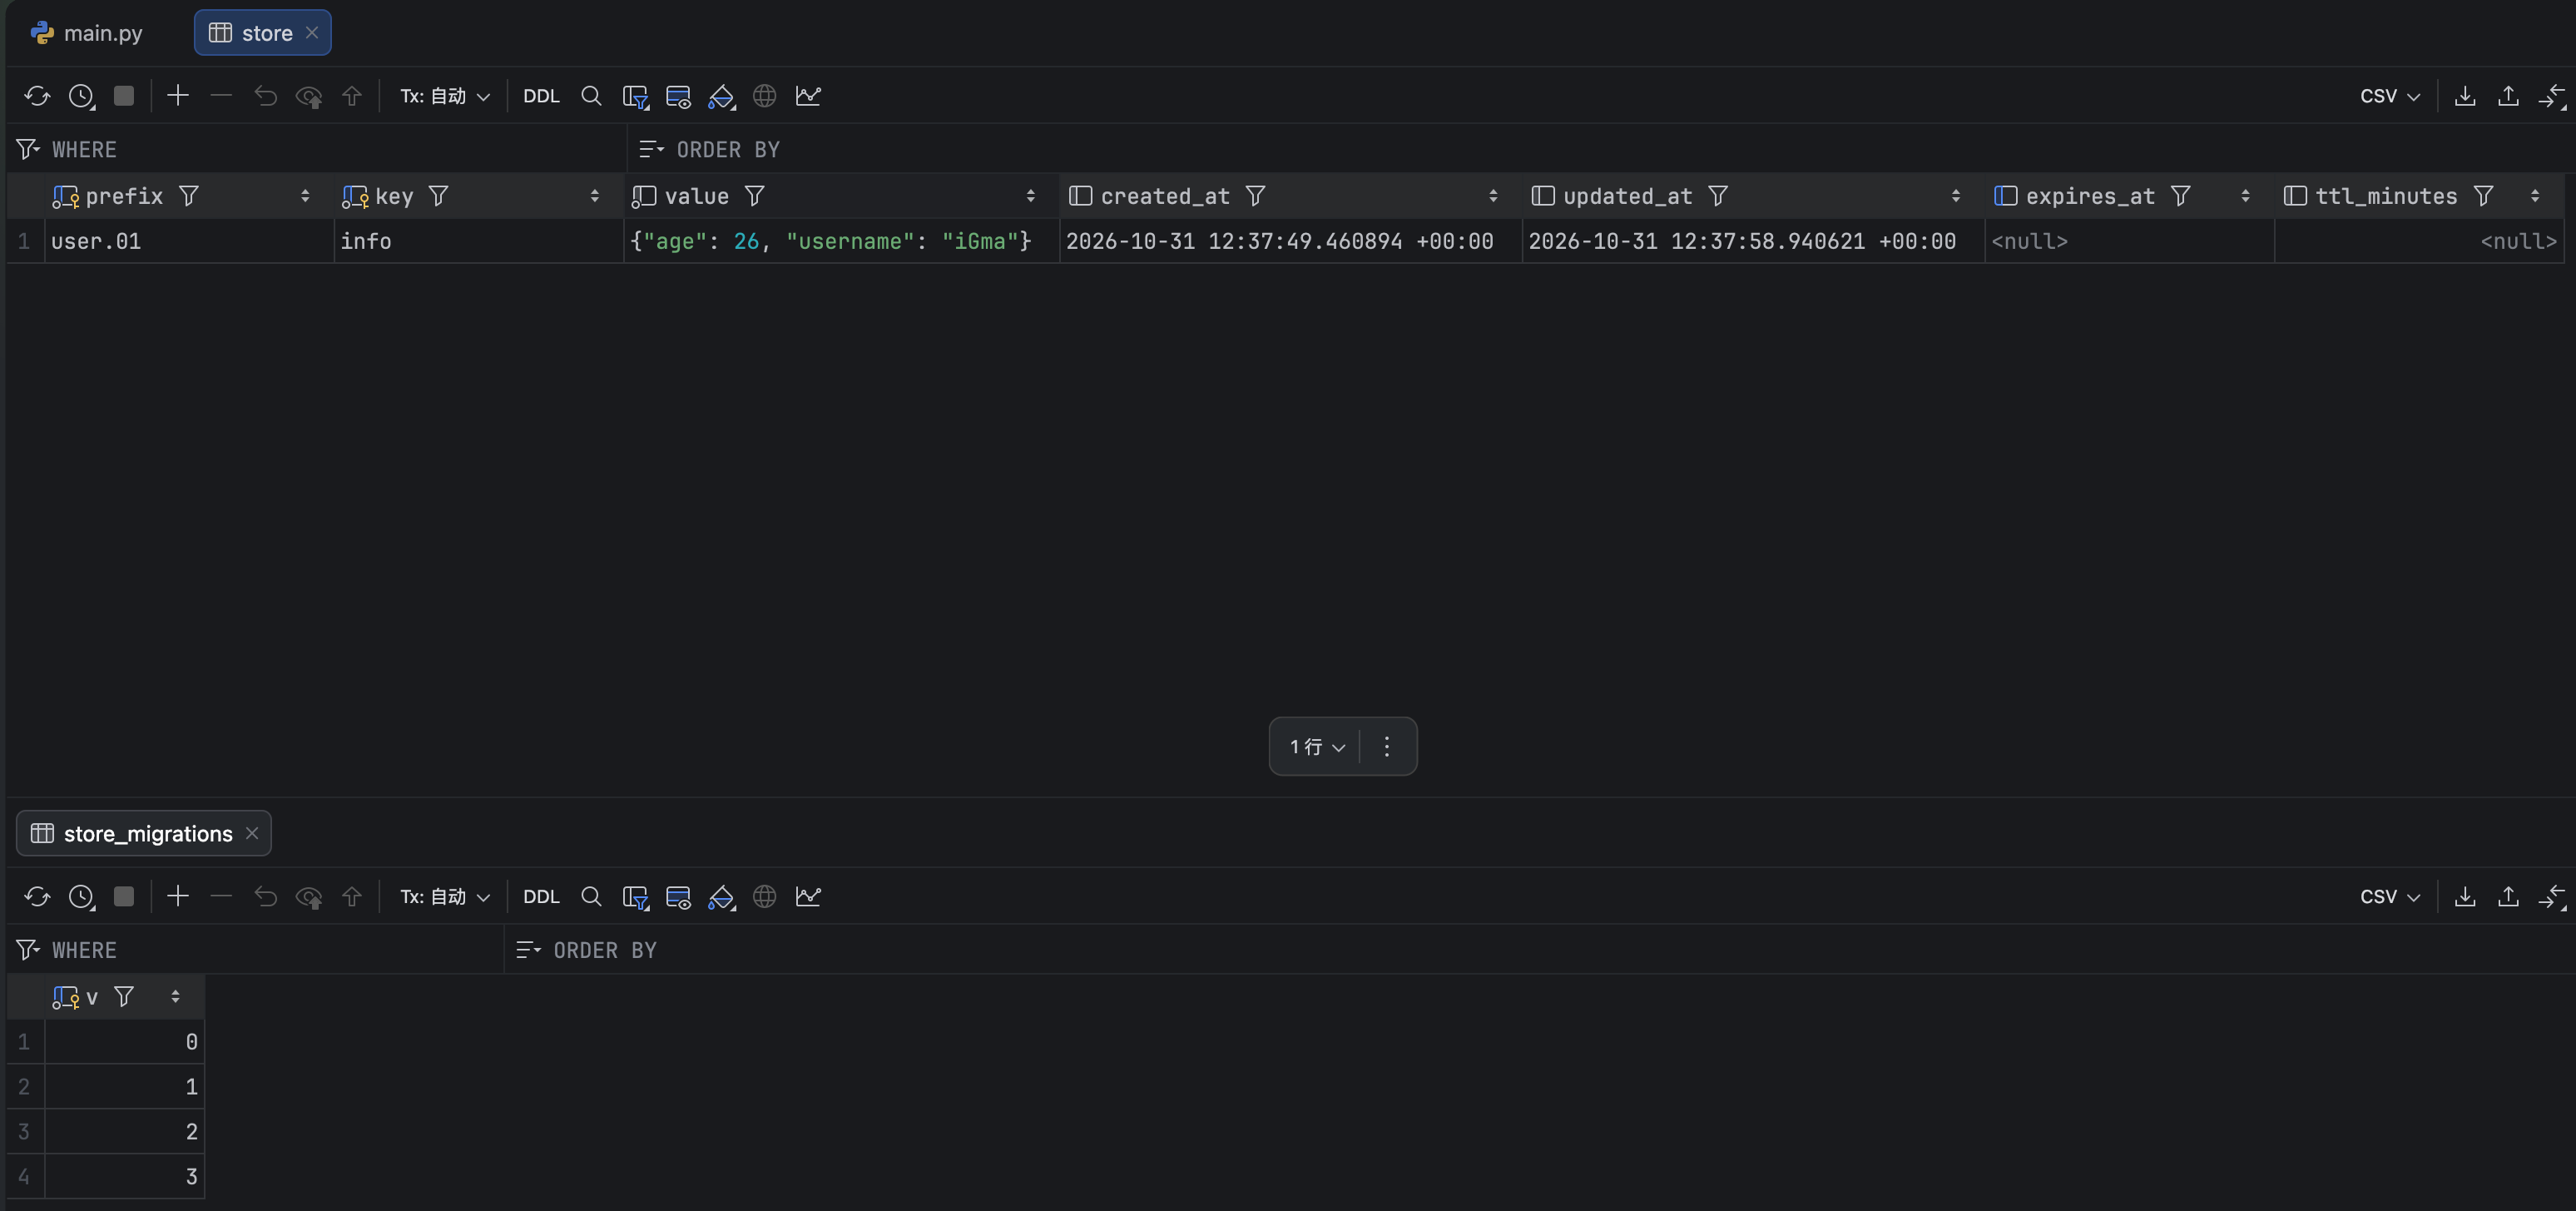
Item(namespace=['user', '01'], key='info', value={'age': 26, 'username': 'iGma'}, created_at='2026-10-31T20:37:49.460894+08:00', updated_at='2026-10-31T20:37:58.940621+08:00')
"""
search 检索
参数:
- namespace_prefix:命名空间前缀,在该前缀下搜索。
- query:语义检索时用于查询的自然语言。
- filter:过滤条件,value中的键值对组合。
- limit:可以返回item的最大条数,效果等同于SQL中的limit。
- offset:返回结果之前跳过的item数量。
- refresh_ttl:同上。
python
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

store.put(
    ("user", "iGma"),
    "info",
    {"gender": "男", "age": 26}
)
store.put(
    ("user", "Bom"),
    "info",
    {"gender": "男", "age": 20}
)
store.put(
    ("user", "Tom"),
    "info",
    {"gender": "女", "age": 18}
)

for item in store.search(("user",)):
    print(item)

""" 输出结果:
Item(namespace=['user', 'iGma'], key='info', value={'gender': '男', 'age': 26}, created_at='2026-10-31T12:56:52.315227+00:00', updated_at='2026-10-31T12:56:52.315414+00:00', score=None)
Item(namespace=['user', 'Bom'], key='info', value={'gender': '男', 'age': 20}, created_at='2026-10-31T12:56:52.315427+00:00', updated_at='2026-10-31T12:56:52.315428+00:00', score=None)
Item(namespace=['user', 'Tom'], key='info', value={'gender': '女', 'age': 18}, created_at='2026-10-31T12:56:52.315433+00:00', updated_at='2026-10-31T12:56:52.315434+00:00', score=None)
"""python
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

store.put(
    ("user", "iGma"),
    "info",
    {"gender": "男", "age": 26}
)
store.put(
    ("user", "Bom"),
    "info",
    {"gender": "男", "age": 20}
)
store.put(
    ("user", "Tom"),
    "info",
    {"gender": "女", "age": 18}
)

for item in store.search(("user",), filter={"gender": "男"}):
    print(item)

""" 输出结果:
Item(namespace=['user', 'iGma'], key='info', value={'gender': '男', 'age': 26}, created_at='2026-10-31T12:58:17.958880+00:00', updated_at='2026-10-31T12:58:17.959074+00:00', score=None)
Item(namespace=['user', 'Bom'], key='info', value={'gender': '男', 'age': 20}, created_at='2026-10-31T12:58:17.959087+00:00', updated_at='2026-10-31T12:58:17.959088+00:00', score=None)
"""query 这种方式涉及到后面的知识,后面补齐。
Agent 访问长期记忆
python
import os
from typing import NotRequired
from dotenv import load_dotenv
from langchain.agents import create_agent, AgentState
from langchain.chat_models import init_chat_model
from langchain_core.tools import tool
from langgraph.prebuilt import ToolRuntime
from langgraph.store.memory import InMemoryStore

load_dotenv(verbose=True)

class AgentStateSchema(AgentState):
    user_id: NotRequired[str]

@tool(parse_docstring=True)
def save_user_info(name: str, gender: str, age: int, runtime: ToolRuntime):
    """存储用户信息

    Args:
        name: 姓名
        gender: 性别
        age: 年龄
    """
    runtime.store.put(("user",), runtime.state["user_id"], {"name": name, "gender": gender, "age": age})

@tool(description="查询用户信息")
def get_user_info(runtime: ToolRuntime):
    item = runtime.store.get(("user",), runtime.state["user_id"])
    return str(item.value) if item else "没找到用户信息"

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    store=InMemoryStore(),
    tools=[save_user_info, get_user_info],
    state_schema=AgentStateSchema,
    system_prompt="用户表明信息时使用工具存储信息,用户查询信息时同样用工具查"
)

count = 1

def run(user_input: str):
    global count
    print("=" * 30, f"第{count}次访问", "=" * 30)
    res = agent.invoke({
        "messages": [user_input],
        "user_id": "1"
    })
    for msg in res["messages"]:
        msg.pretty_print()
    count += 1

run("我是 iGma,男,今年 26 岁,很高兴认识你")
run("我是谁")

""" 输出结果:
============================== 第1次访问 ==============================
================================ Human Message =================================

我是 iGma,男,今年 26 岁,很高兴认识你
================================== Ai Message ==================================
Tool Calls:
  save_user_info (call_00_iDI1w3tQUkvrA4vgZiKP3779)
 Call ID: call_00_iDI1w3tQUkvrA4vgZiKP3779
  Args:
    name: iGma
    gender: 男
    age: 26
================================= Tool Message =================================
Name: save_user_info

null
================================== Ai Message ==================================

很高兴认识你,iGma!我已经记下了你的信息:男,26 岁。有什么我可以帮你的吗?
============================== 第2次访问 ==============================
================================ Human Message =================================

我是谁
================================== Ai Message ==================================
Tool Calls:
  get_user_info (call_00_ItTgKm2LLKai6PQmsVjj9273)
 Call ID: call_00_ItTgKm2LLKai6PQmsVjj9273
  Args:
================================= Tool Message =================================
Name: get_user_info

{'name': 'iGma', 'gender': '男', 'age': 26}
================================== Ai Message ==================================

根据存储的信息,你是 **iGma**,男性,26 岁。
"""python
import os
from typing import NotRequired
from dotenv import load_dotenv
from langchain.agents import create_agent, AgentState
from langchain.chat_models import init_chat_model
from langchain_core.tools import tool
from langgraph.prebuilt import ToolRuntime
from langgraph.store.postgres import PostgresStore

load_dotenv(verbose=True)

class AgentStateSchema(AgentState):
    user_id: NotRequired[str]

@tool(parse_docstring=True)
def save_user_info(name: str, gender: str, age: int, runtime: ToolRuntime):
    """存储用户信息

    Args:
        name: 姓名
        gender: 性别
        age: 年龄
    """
    runtime.store.put(("user",), runtime.state["user_id"], {"name": name, "gender": gender, "age": age})

@tool(description="查询用户信息")
def get_user_info(runtime: ToolRuntime):
    item = runtime.store.get(("user",), runtime.state["user_id"])
    return str(item.value) if item else "没找到用户信息"

DB_URL = "postgresql://igma:123123@localhost:5432/langchain_db?sslmode=disable"

with PostgresStore.from_conn_string(DB_URL) as db:
    db.setup()
    agent = create_agent(
        model=init_chat_model(
            model="deepseek-flash",
            api_key=os.getenv("DEEPSEEK_API_KEY"),
            base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
        ),
        store=db,
        tools=[save_user_info, get_user_info],
        state_schema=AgentStateSchema,
        system_prompt="用户表明信息时使用工具存储信息,用户查询信息时同样用工具查"
    )

    count = 1

    def run(user_input: str):
        global count
        print("=" * 30, f"第{count}次访问", "=" * 30)
        res = agent.invoke({
            "messages": [user_input],
            "user_id": "1"
        })
        for msg in res["messages"]:
            msg.pretty_print()
        count += 1

    run("我是 iGma,男,今年 26 岁,很高兴认识你")
    run("我是谁")

""" 输出结果:
============================== 第1次访问 ==============================
================================ Human Message =================================

我是 iGma,男,今年 26 岁,很高兴认识你
================================== Ai Message ==================================
Tool Calls:
  save_user_info (call_00_B251XH1YRMX5WTPVIZyA9135)
 Call ID: call_00_B251XH1YRMX5WTPVIZyA9135
  Args:
    name: iGma
    gender: 男
    age: 26
================================= Tool Message =================================
Name: save_user_info

null
================================== Ai Message ==================================

很高兴认识你,iGma!😊

我已经记下你的信息了:iGma,男,26 岁。以后需要查询时随时告诉我。有什么我可以帮你的吗?
============================== 第2次访问 ==============================
================================ Human Message =================================

我是谁
================================== Ai Message ==================================
Tool Calls:
  get_user_info (call_00_eCcm3AgZwtNFcAMMomed7916)
 Call ID: call_00_eCcm3AgZwtNFcAMMomed7916
  Args:
================================= Tool Message =================================
Name: get_user_info

{'age': 26, 'name': 'iGma', 'gender': '男'}
================================== Ai Message ==================================

你是 **iGma**,男性,今年 26 岁。
"""在中间件中访问长期记忆
python
import os
from typing import NotRequired
from dotenv import load_dotenv
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import before_model
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage, AIMessage
from langgraph.store.memory import InMemoryStore

load_dotenv(verbose=True)

class AgentStateSchema(AgentState):
    user_id: NotRequired[str]

@before_model(can_jump_to=["end"])
def before_model_init(state, runtime):
    last_msg = state["messages"][-1]

    if type(last_msg) == HumanMessage:
        if "我是谁" in last_msg.content:
            res = runtime.store.get(("user",), "info").value
            return {
                "messages": [AIMessage(f"这是一条伪造的消息:你是{res["name"]},{res["gender"]},{res["age"]}岁")],
                "jump_to": "end"
            }
        elif "我是" in last_msg.content:
            runtime.store.put(("user",), "info", {"name": "iGma", "age": 26, "gender": "男"})

    return None

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    store=InMemoryStore(),
    state_schema=AgentStateSchema,
    middleware=[before_model_init]
)

def run(user_input: str):
    res = agent.invoke({
        "messages": [user_input],
        "user_id": "1"
    })
    for msg in res["messages"]:
        msg.pretty_print()

run("我是 iGma,男,今年 26 岁,很高兴认识你")
run("我是谁")

""" 输出结果:
================================ Human Message =================================

我是 iGma,男,今年 26 岁,很高兴认识你
================================== Ai Message ==================================

iGma,你好,很高兴认识你!我是你的 AI 助手,有什么想聊的或需要帮忙的,尽管告诉我。
================================ Human Message =================================

我是谁
================================== Ai Message ==================================

这是一条伪造的消息:你是iGma,男,26岁
"""python
import os
from typing import NotRequired
from dotenv import load_dotenv
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import wrap_model_call, ModelResponse
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage, AIMessage
from langgraph.store.memory import InMemoryStore

load_dotenv(verbose=True)

class AgentStateSchema(AgentState):
    user_id: NotRequired[str]

@wrap_model_call
def warp_model_init(request, handler):
    last_msg = request.messages[-1]
    if type(last_msg) == HumanMessage and "我是谁" in last_msg.content:
        res = request.runtime.store.get(("user",), "info").value
        return ModelResponse(
            result=[AIMessage(f"这是一条伪造的消息:你是{res["name"]},{res["gender"]},{res["age"]}岁")]
        )
    res = handler(request)
    if type(last_msg) == HumanMessage and "我是" in last_msg.content:
        request.runtime.store.put(("user",), "info", {"name": "iGma", "age": 26, "gender": "男"})
    return res

agent = create_agent(
    model=init_chat_model(
        model="deepseek-flash",
        api_key=os.getenv("DEEPSEEK_API_KEY"),
        base_url=os.getenv("DEEPSEEK_API_BASE_URL"),
    ),
    store=InMemoryStore(),
    state_schema=AgentStateSchema,
    middleware=[warp_model_init]
)

def run(user_input: str):
    res = agent.invoke({
        "messages": [user_input],
        "user_id": "1"
    })
    for msg in res["messages"]:
        msg.pretty_print()

run("我是 iGma,男,今年 26 岁,很高兴认识你")
run("我是谁")

""" 输出结果:
================================ Human Message =================================

我是 iGma,男,今年 26 岁,很高兴认识你
================================== Ai Message ==================================

你好,iGma,很高兴认识你!我是 AI 助手,可以陪你聊天、解答问题、帮忙整理思路或处理各种任务。今天有什么想聊的,或者需要我帮忙的吗?
================================ Human Message =================================

我是谁
================================== Ai Message ==================================

这是一条伪造的消息:你是iGma,男,26岁
"""何时写入记忆
- 热路径:在主流程里写,用户发消息,AI 一边回答,一边决定要不要记下来。
- 优点:
- 立即生效
- 下一轮马上能用
- 用户可感知,透明
- 缺点:
- 增加延迟
- 逻辑变复杂
- 优点:
- 在后台写:就是先回答用户,记忆整理放到后台
异步做。- 优点:
- 主流程更快
- 记忆逻辑更独立
- 更适合批量整理
- 缺点:
- 不能立刻生效
- 要决定多久整理一次
- 触发时机不好选
- 优点:
工程上通常这么选:
用户偏好、账号资料:可热路径写对话摘要、经验沉淀、行为分析:更适合后台写