搜索文档
安装 Docker Desktop
设置中文
下载汉化包:https://github.com/asxez/DockerDesktop-CN/releases
根据 官方文档 一步步执行即可,他这里的一键安装有点不好用,推荐使用手动安装。
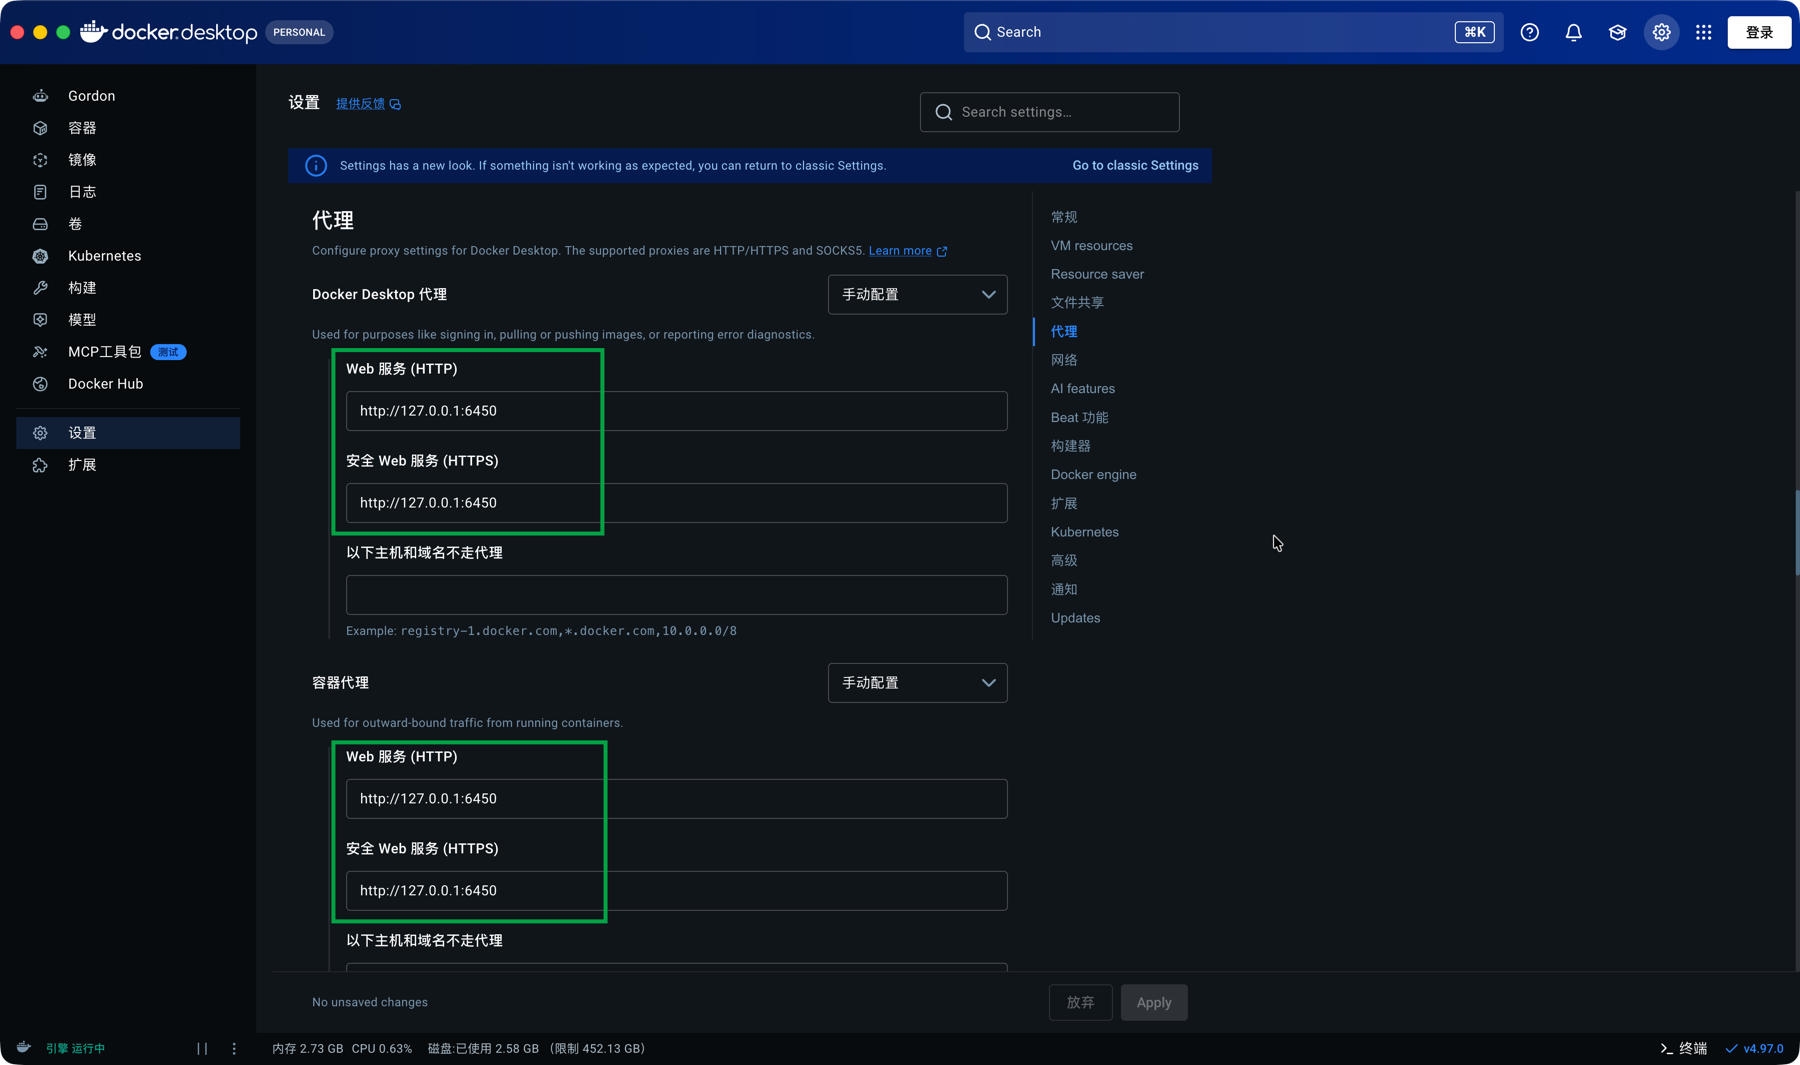
设置 Proxy
有条件的翻个墙,把代理服务的端口放到这里
准备 Milvus
下载
bash
curl -L -o docker-compose.yml https://github.com/milvus-io/milvus/releases/download/v2.5.4/milvus-standalone-docker-compose.yml启动
bash
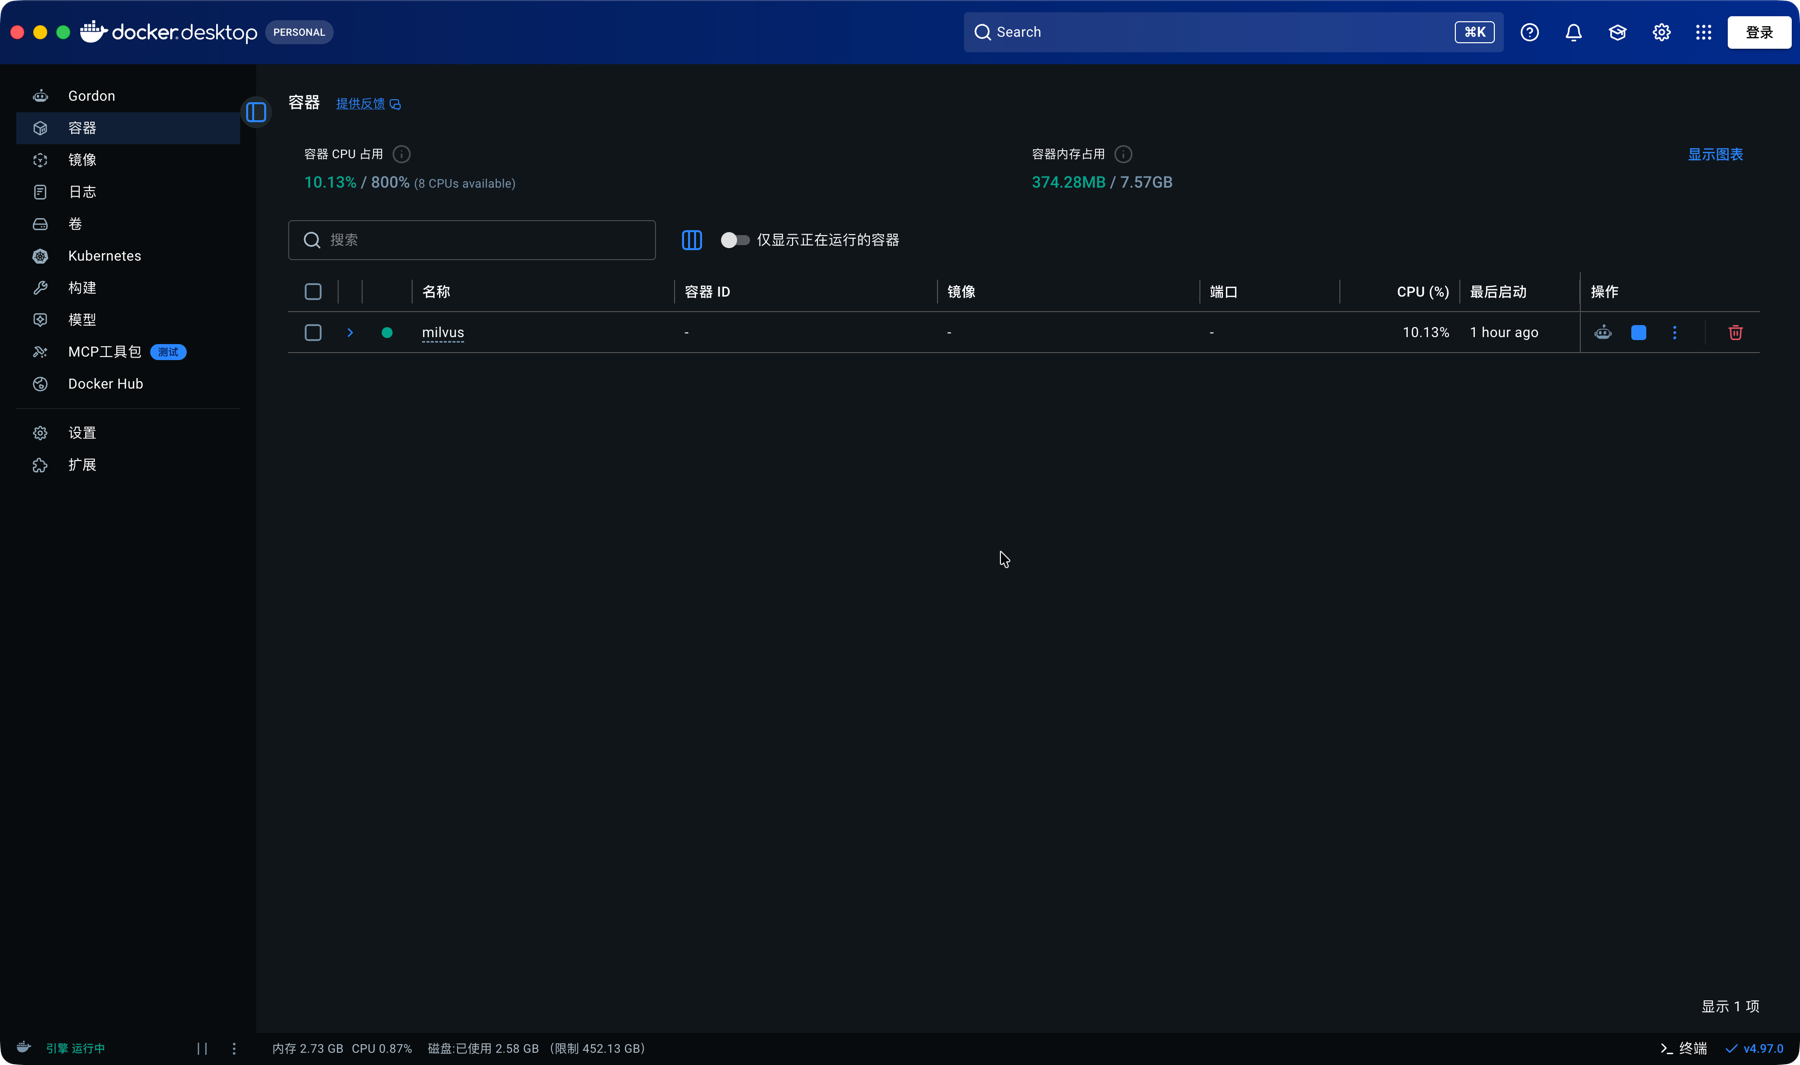
docker compose up -d启动成功后在 Docker Desktop 软件如下图所示
数据库结构
- Database:数据库,用来隔离不同业务数据。
- Collection:最核心的逻辑容器,类似于关系型数据库里的 Table。
- Partition:分区,是
Collection的子集,不是必须手动创建。一个Collection至少会有默认Partition。 - Entity:可以理解为
Collection中的一条记录。类似于关系型数据库的一行数据。
默认端口号
根据官方文档,Milvus Standalone 默认会使用这几个端口:
- 19530:这是 Milvus 的核心端口,你的 Python 代码或任何客户端连接 Milvus 时用的就是这个端口。
- 9091:这是健康检查和 WebUI 端口。你之前访问的 http://127.0.0.1:9091/webui/ 就是通过它。
DDL 操作
Database
- 新建数据库时必须确保数据库名不能重复,否则会报错。
- 删除数据库时,如果数据库下有
Collection则无法删除,需要先删除它的所有Collection才能删除Database。
python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

# 查看所有数据库
dbs = client.list_databases()

for db in dbs:
    print(db)

""" 输出结果:
default
"""python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

dbs = client.list_databases()

db_name = "rag_db"

if db_name not in dbs:
    # 新建数据库
    client.create_database(db_name)

for db in dbs:
    print(db)

""" 输出结果:
rag_db
default
"""python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

# 删除数据库
client.drop_database("rag_db")

dbs = client.list_databases()

for db in dbs:
    print(db)

""" 输出结果:
default
"""python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

dbs = client.list_databases()

db_name = "rag_db"

if db_name not in dbs:
    client.create_database(db_name)

# 切换数据库
client.use_database(db_name)Collection
基础用法
- 所有的容器操作前必须切换到指定的数据库,否则相当于对
default数据库的操作。 - 新容器入参:
- collection_name:容器名。
- dimension:嵌入向量维度,应和嵌入模型的向量维度保持一致。
- metric_type:表示向量相似度的计算方式,可选值:
- COSINE:默认值,余弦相似度。衡量向量方向的一致性,取值通常在 -1 到 1 之间,值越大越相似。适合文本嵌入等场景,也是客户端快捷创建时的默认值。
- L2:欧氏距离。衡量向量在空间中的直线距离,值越小表示越相似。适合对绝对距离敏感、未归一化的数据。
- IP:内积(点积)。值越大越相似。如果向量已经做过归一化,
IP和COSINE的效果是等价的。
- schema:数据表的设计图纸,它规定了这张表里有哪些字段、每个字段叫什么名字、存什么类型的数据(比如整数、文本、向量),以及哪个字段是主键。
python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

client.use_database("rag_db")

# 查看 rag_db 下所有容器
cs = client.list_collections()

print(cs)

""" 输出结果:
[]
"""python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

client.use_database("rag_db")

# 新建容器
client.create_collection(
    collection_name="docs",
    dimension=1024,
    metric_type="COSINE",
)

cs = client.list_collections()

print(cs)

""" 输出结果:
['docs']
"""python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")

client.use_database("rag_db")

# 删除容器
client.drop_collection("docs")

cs = client.list_collections()

print(cs)

""" 输出结果:
[]
"""自定义字段
- 通过
schema指定自定义字段,值是通过create_schema()创建的schema对象,参数如下:参数名 类型 说明 auto_id bool 是否允许主键字段自动递增。设为 True 时,插入数据不应包含主键字段,由 Milvus 自动生成。 enable_dynamic_field bool 是否启用动态字段。启用后,插入数据中未在 schema 定义的字段会存入保留的 $meta 字段中。 primary_field str 主键字段的名称。通常在你通过 add_field 指定 is_primary=True 时已确定,这个参数用于显式指定名称。 partition_key_field str 作为分区键的字段名称。设置后,Milvus 会根据该字段的哈希值自动管理数据分区,常用于多租户场景。 external_source str 外部数据源的 URI(如 S3 路径)。用于创建映射到外部存储的集合,而非 Milvus 内部管理的数据。 external_spec str 外部数据源的规格参数,通常是一个 JSON 字符串,用于指定格式(如 parquet)等细节。 - 创建
schema对象后通过add_field()方法创建字段,参数如下:参数名 类型 说明 field_name str 必需。字段的名称。 datatype DataType 必需。字段的数据类型。 is_primary bool 是否为主键字段。每个集合只能有一个主键,且类型必须为 INT64或VARCHAR。max_length int VARCHAR字段允许的最大字节长度,范围[1, 65535]。对VARCHAR字段必需。dim int 向量维度。对 FLOAT_VECTOR、BINARY_VECTOR 等稠密向量字段必需;稀疏向量SPARSE_FLOAT_VECTOR无需设置。element_type DataType ARRAY 字段中元素的数据类型。对 ARRAY 字段必需 max_capacity int ARRAY 字段中元素的最大数量。对 ARRAY 字段必需。 is_partition_key bool 是否作为分区键。每个集合只能有一个分区键。Milvus Lite 不支持此参数。 is_clustering_key bool 是否作为聚类键。 mmap_enabled bool 是否将字段数据映射到内存而非完全加载。 nullable bool 字段是否允许空值。默认 False。 default_value DataType 字段默认值 analyzer_params dict 为 VARCHAR 字段配置文本分析器(分词、过滤等),用于关键词匹配或全文搜索。 - DataType 可用类型:
类型常量 分类 说明 BOOL标量 布尔值 INT8/INT16/INT32/INT64标量 不同位宽的整数。主键只能用 INT64或VARCHARFLOAT/DOUBLE标量 单精度 / 双精度浮点数 VARCHAR标量 变长字符串,需配合 max_length TEXT标量 长文本,无需 max_length(较新版本支持) JSON标量 JSON 对象 ARRAY标量 数组,需配合 element_type 和 max_capacity GEOMETRY标量 几何/空间数据(较新版本支持) TIMESTAMPTZ标量 带时区的时间戳(较新版本支持) BINARY_VECTOR向量 二值向量,维度需为 8 的倍数 FLOAT_VECTOR向量 最常用的稠密浮点向量 FLOAT16_VECTOR/BFLOAT16_VECTOR向量 半精度浮点向量,节省内存 SPARSE_FLOAT_VECTOR向量 稀疏向量,用于 BM25 等场景,无需指定维度 INT8_VECTOR向量 INT8 量化向量(较新版本支持) STRUCT复合 结构体数组元素类型(较新版本支持)
python
from pymilvus import MilvusClient, DataType
from rich import print as rprint

client = MilvusClient("http://localhost:19530")
client.use_database("rag_db")

schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
schema.add_field(field_name="my_id", datatype=DataType.INT64, is_primary=True)
schema.add_field(field_name="my_vector", datatype=DataType.FLOAT_VECTOR, dim=768)
schema.add_field(field_name="my_text", datatype=DataType.VARCHAR, max_length=512)

client.create_collection(
    collection_name="test",
    dimension=1024,
    metric_type="COSINE",
    schema=schema
)

metadata = client.describe_collection("test")

rprint(metadata)
""" 输出结果:
{
    'collection_name': 'test',
    'auto_id': False,
    'num_shards': 1,
    'description': '',
    'fields': [
        {
            'field_id': 100,
            'name': 'my_id',
            'description': '',
            'type': <DataType.INT64: 5>,
            'params': {},
            'is_primary': True
        },
        {
            'field_id': 101,
            'name': 'my_vector',
            'description': '',
            'type': <DataType.FLOAT_VECTOR: 101>,
            'params': {'dim': 768}
        },
        {
            'field_id': 102,
            'name': 'my_text',
            'description': '',
            'type': <DataType.VARCHAR: 21>,
            'params': {'max_length': 512}
        }
    ],
    'functions': [],
    'aliases': [],
    'collection_id': 470184991754880098,
    'consistency_level': 2,
    'properties': {'timezone': 'UTC'},
    'num_partitions': 1,
    'enable_dynamic_field': False,
    'enable_namespace': False,
    'created_timestamp': 470192412022013970,
    'update_timestamp': 470192412022013970
}
"""DML 操作
准备嵌入模型
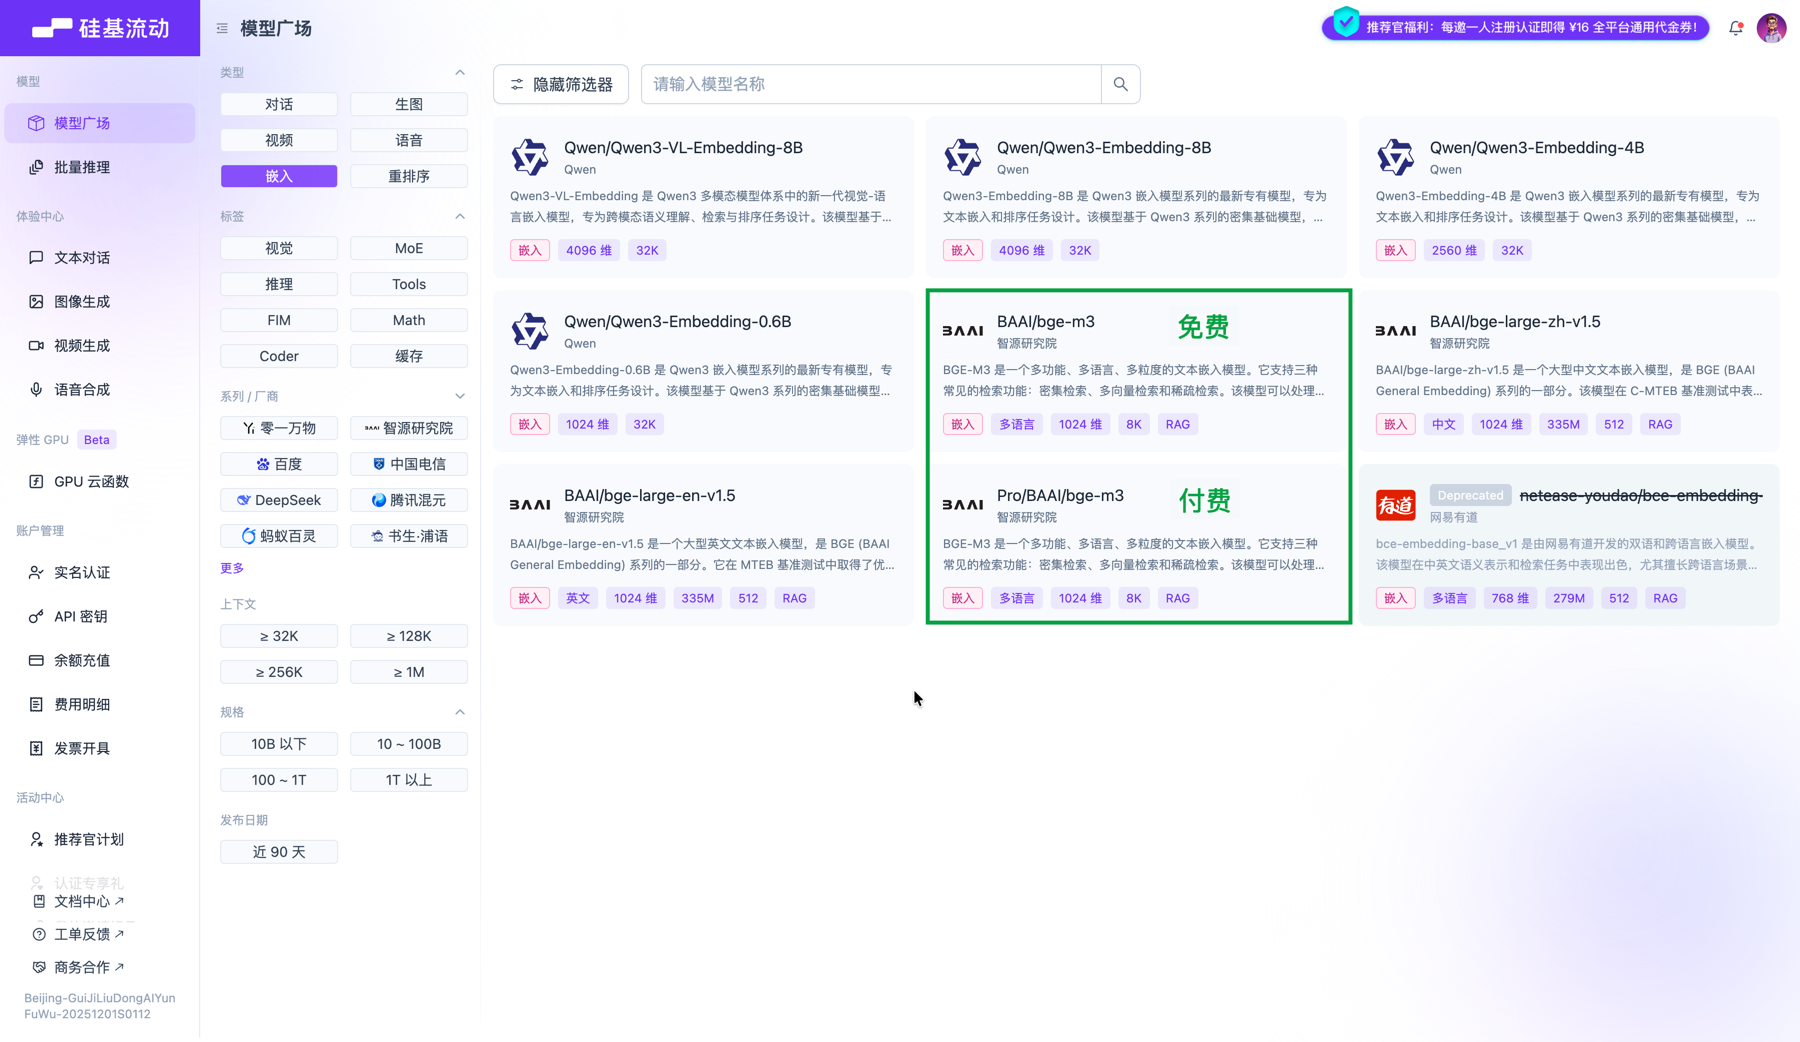
在 硅基流动 平台选择 bge-m3 作为嵌入模型,该模型可以免费调用,如果追求更低的延迟、更稳定的服务,也可以充值后选择带有 pro 前缀的模型。
准备数据库和容器
- 当我们创建容器时不添加自定义字段,
fields中默认会有两个字段:- id:数据ID,作为主键唯一标识数据。
- vector:数据的嵌入向量。
enable_dynamic_field: True表示该容器支持动态字段。
python
from pymilvus import MilvusClient
from rich import print as rprint

client = MilvusClient("http://localhost:19530")

DB_NAME = "rag_db"
COLLECTION_NAME = "docs"

client.create_database(DB_NAME)
client.use_database(DB_NAME)
client.create_collection(COLLECTION_NAME, dimension=1024)

# 查看元数据(等同于关系数据库中的表结构 )
metadata = client.describe_collection(COLLECTION_NAME)

rprint(metadata)

""" 输出结果:
    'collection_name': 'docs',
    ...
    'fields': [
        {
            'field_id': 100,
            'name': 'id',
            'description': '',
            'type': <DataType.INT64: 5>,
            'params': {},
            'is_primary': True
        },
        {
            'field_id': 101,
            'name': 'vector',
            'description': '',
            'type': <DataType.FLOAT_VECTOR: 101>,
            'params': {'dim': 1024}
        }
    ],
    ...
    'enable_dynamic_field': True,
    ...
}
"""写入数据
python
import os
from dotenv import load_dotenv
from langchain_openai import OpenAIEmbeddings
from pymilvus import MilvusClient

COLLECTION_NAME = "docs"

client = MilvusClient("http://localhost:19530")
client.use_database("rag_db")

client.create_collection(
    collection_name=COLLECTION_NAME,
    dimension=1024,
    metric_type="COSINE",
)

load_dotenv(verbose=True)

model = OpenAIEmbeddings(
    model="BAAI/bge-m3",
    api_key=os.getenv("SILICONFLOW_API_KEY"),
    base_url=os.getenv("SILICONFLOW_BASE_URL"),
)

texts = [
    "LangChain 是一个用于构建 LLM 应用的开发框架。",
    "Milvus 是一个适合 AI 应用的向量数据库。",
    "RAG 的核心是先检索相关知识,再让大模型生成答案。",
    "Docker Desktop 可以方便地在本地运行 Milvus Standalone。"
]

embed_data = model.embed_documents(texts)

db_data = [
    {"id": i, "vector": embed_data[i], "text": texts[i]}
    for i in range(len(texts))
]

# 写入数据
client.upsert(COLLECTION_NAME, db_data)

# 手动 Flush
client.flush(COLLECTION_NAME)

# 查看状态
stats = client.get_collection_stats(COLLECTION_NAME)
print(stats)

""" 输出结果:
{'row_count': 4}
"""DQL 操作
查询全部数据
通过 query_iterator() 方法查询所有数据,参数如下:
| 参数名 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| collection_name | str | 必填 | 要查询的集合名称。 |
| batch_size | Optional[int] | 1000 | 每次调用 next() 时返回的数据条数。控制分批查询的“页大小”。 |
| limit | Optional[int] | UNLIMITED | 迭代器总共能返回的最大数据条数。达到该值后迭代器会停止返回数据。 |
| filter | Optional[str] | "" | 标量过滤条件(布尔表达式)。为空字符串时表示查询所有数据。 |
| output_fields | Optional[List[str]] | None | 指定返回结果中包含的字段列表。若为 None,通常仅返回主键。传入 ["*"] 可返回所有字段。 |
| partition_names | Optional[List[str]] | None | 指定要查询的分区名称列表。若不指定,则查询整个集合。(注:Milvus Lite 不支持分区) |
| timeout | Optional[float | int] | None | 单次查询请求的超时时间(秒)。 |
| **kwargs | Any | - | 接受其他进阶参数,例如 consistency_level(一致性级别)、offset(偏移量)等。 |
python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")
client.use_database("rag_db")

db_data = client.query_iterator(
    collection_name="docs",
    batch_size=100,
    output_fields=["*"]
)

while True:
    rows = db_data.next()
    if not rows:
        break
    i = 1
    for row in rows:
        print("=" * 50, f"第 {i} 组数据", "=" * 50)
        print(row)
        i += 1

""" 输出结果:
================================================== 第 1 组数据 ==================================================
{'id': 0, 'vector': [-0.00875447504222393, 0.049498990178108215, ...], 'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。'}
================================================== 第 2 组数据 ==================================================
{'id': 1, 'vector': [-0.023555606603622437, 0.003576694754883647, ...], 'text': 'Milvus 是一个适合 AI 应用的向量数据库。'}
================================================== 第 3 组数据 ==================================================
{'id': 2, 'vector': [-0.015065424144268036, 0.03790215402841568, ...], 'text': 'RAG 的核心是先检索相关知识,再让大模型生成答案。'}
================================================== 第 4 组数据 ==================================================
{'id': 3, 'vector': [0.0038988213054835796, 0.013032680377364159, ...], 'text': 'Docker Desktop 可以方便地在本地运行 Milvus Standalone。'}
"""通过主键查询数据
通过 get() 方法查询指定主键的数据,参数如下:
| 参数名 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| collection_name | str | 必填 | 要查询的集合名称。 |
| ids | Union[list, str, int] | 必填 | 要获取数据的主键 ID。可以传入单个 ID(如 1 或 "abc"),也可以传入 ID 列表(如 [1, 2, 3])。 |
| output_fields | Optional[List[str]] | None | 指定返回结果中包含的字段列表。若为 None,通常仅返回主键。传入 ["*"] 可返回所有字段。 |
| timeout | Optional[float | int] | None | 单次查询请求的超时时间(秒)。 |
| partition_names | Optional[List[str]] | None | 指定要查询的分区名称列表。若不指定,则查询整个集合。(注:Milvus Lite 不支持分区) |
| **kwargs | Any | - | 接受其他进阶参数,例如 consistency_level(一致性级别)等。 |
返回值:List[dict],返回包含查询结果的字典列表。
python
from pymilvus import MilvusClient

client = MilvusClient("http://localhost:19530")
client.use_database("rag_db")

db_data = client.get(
    collection_name="docs",
    ids=[0, 1],
)

i = 1
for item in db_data:
    print("=" * 50, f"第 {i} 组数据", "=" * 50)
    print(item)
    i += 1

""" 输出结果:
================================================== 第 1 组数据 ==================================================
{'id': 0, 'vector': [-0.00875447504222393, 0.049498990178108215, ...], 'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。'}
================================================== 第 2 组数据 ==================================================
{'id': 1, 'vector': [-0.023555606603622437, 0.003576694754883647, ...], 'text': 'Milvus 是一个适合 AI 应用的向量数据库。'}
"""相似度检索
- 首先使用嵌入模型将用户输入的问题转成向量。
- 通过
search()方法去数据库中检索,参数如下:
| 参数名 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| collection_name | str | 必填 | 要在哪个集合中进行搜索。 |
| data | Optional[Union[List[list], list]] | None | 要搜索的查询向量。可以传单个向量(如 [[0.1, 0.2, ...]]),也可以传多个向量批量搜索。 |
| filter | str | "" | 标量过滤条件(布尔表达式)。在向量搜索前先过滤数据,例如 "age > 18"。 |
| limit | int | 10 | 返回的最相似结果数量(Top K)。 |
| output_fields | Optional[List[str]] | None | 指定返回结果中包含的标量字段列表。若为 None,通常仅返回主键和距离。传入 ["*"] 可返回所有字段。 |
| search_params | Optional[dict] | None | 搜索参数,用于指定索引相关的搜索配置(如 {"metric_type": "COSINE", "params": {"ef": 64}})。若为 None 则使用默认设置。 |
| timeout | Optional[float | int] | None | 单次搜索请求的超时时间(秒)。 |
| partition_names | Optional[List[str]] | None | 指定在哪些分区中进行搜索。若不指定,则搜索整个集合。(注:Milvus Lite 不支持) |
| anns_field | Optional[str] | None | 指定要在哪个向量字段上进行搜索。如果集合只有一个向量字段,可省略。 |
| ranker | Optional[Union[Function, FunctionScore]] | None | 指定重排器(如混合搜索时的 RRF 重排)。用于多向量字段的联合搜索场景。 |
| highlighter | Optional[Highlighter] | None | 用于全文搜索(Full-Text Search)时,对匹配到的关键词进行高亮显示。 |
| ids | Optional[Union[List[int], List[str], str, int]] | None | 限定只在指定的主键 ID 列表范围内进行搜索。 |
| **kwargs | Any | - | 接受其他进阶参数,例如 consistency_level(一致性级别)、offset(分页偏移量)等。 |
返回值:List[List[dict]]。返回一个嵌套列表,外层列表对应你传入的每一个查询向量,内层列表包含该查询向量的 Top K 结果(包含 id、distance 以及 entity 中的输出字段)。
python
import os
from dotenv import load_dotenv
from langchain_openai import OpenAIEmbeddings
from pymilvus import MilvusClient
from rich import print as rprint

client = MilvusClient("http://localhost:19530")
client.use_database("rag_db")

load_dotenv(verbose=True)

model = OpenAIEmbeddings(
    model="BAAI/bge-m3",
    api_key=os.getenv("SILICONFLOW_API_KEY"),
    base_url=os.getenv("SILICONFLOW_BASE_URL"),
)

res = client.search(
    collection_name="docs",
    data=[model.embed_query("什么是向量数据库?")],  # 这里是个二维数组
    limit=3,
    output_fields=["id", "text"]
)

# 返回值 res 也是二维数组,其中 distance 表示相似度,值越高越贴合答案
for item in res[0]:
    rprint(item)

""" 输出结果:
{
    'id': 0,
    'distance': 0.6406217813491821,
    'entity': {
        'id': 0,
        'text': 'LangChain 是一个用于构建 LLM 应用的开发框架。'
    }
}
{
    'id': 3,
    'distance': 0.3116165101528168,
    'entity': {
        'id': 3,
        'text': 'Docker Desktop 可以方便地在本地运行 Milvus Standalone。'
    }
}
{
    'id': 2,
    'distance': 0.30259355902671814,
    'entity': {
        'id': 2,
        'text': 'RAG 的核心是先检索相关知识,再让大模型生成答案。'
    }
}
"""