搜索文档
前置知识
官方文档
- 中文文档:https://docs.langchain.org.cn/oss/python/langchain/models
- 英文文档:https://docs.langchain.com/oss/python/langchain/models
大模型的调用
- 在
GPT-3时代,大模型以补全模型为主,效果非常不稳定。 - 伴随着
GPT-3.5模型的发布,对话模型正式登上历史的舞台,并逐渐成为主流。
模型初始化的分类
简单来说,就是用谁家的API以什么方式创建存放在哪个位置的大模型。
- 调用谁家的API?
- 使用模型提供商的库。
- 使用LangChain统一方式(
推荐)。
- 模型初始化时,几个重要参数(如BASE_URL、API-KEY)的书写位置的不同。
- 使用配置文件(
推荐) - 硬编码:写在代码文件中。
- 使用配置文件(
- 调用的模型所在位置。
- 在线部署的大模型。
- 本地部署的大模型。
LangChain作为一个 工具,不提供任何 LLMs,而是依赖于第三方集成各种大模型。这里就看大模型到底部署在哪里。
线上大模型服务平台
有许多提供大模型API服务的平台,使用时只需要注册、充值并创建 API-Key,之后即可使用 API-Key 与 URL 来调用平台提供的相应的模型的服务。
| 平台 | 网址 | 备注 |
|---|---|---|
| OpenRouter | https://openrouter.ai/ | 全球主流,含国外模型,需要翻墙 |
| CloseAI | https://platform.closeai-asia.com/ | 亚洲最大,含国外模型 |
| 阿里云百炼 | https://bailian.console.aliyun.com/ | 企业端友好 |
| 硅基流动 | https://www.siliconflow.cn/ | 性价比高,适合个人 |
| 百度千帆 | https://console.bce.baidu.com/qianfan/overview | 主打百度生态 |
| 火山引擎 | https://console.volcengine.com/ark/ | 主打字节多模态生态 |
模型初始化-供应商方式
DeepSeek
bash
#切换python环境
conda activate langchain1.2

#安装ChatOpenAI依赖包
pip install langchain-openai

#安装ChatDeepSeek 依赖包
pip install langchain-deepseek

# 用于环境管理的包
pip install python-dotenv- langchain-deepseek 是使用 deepseek 大模型必要依赖。
- langchain-deepseek 依赖于 langchain-openai,安装前者,pip会自动从pypi拉取元数据解析依赖,后者也会被安装。
- 创建
.env配置文件,从 DeepSeek 官网获取 api_key 和 base_url。
dotenv
DEEPSEEK_API_KEY=xxxxxxx
DEEPSEEK_BASE_URL=https://api.deepseek.com- 读取配置并完成模型初始化
python
import os
from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

# 通过 load_dotenv() 将 .env 中的变量加载为环境变量
# override=True表示:无论你当前的操作系统、终端或者虚拟环境中是否已经存在同名的环境变量,都会强行用 .env 文件里写的值去覆盖它
load_dotenv(override=True)

# 从环境变量读取配置
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 创建 DeepSeek LLM
deepseek = ChatDeepSeek(
    api_key = DEEPSEEK_API_KEY,
    api_base = DEEPSEEK_BASE_URL,
    model_name = "deepseek-flash"
)

# 通过 invoke 像 LLM 提出问题
print(deepseek.invoke("请介绍一下你自己"))python
from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

# 通过 load_dotenv() 将 .env 中的变量加载为环境变量
# override=True表示:无论你当前的操作系统、终端或者虚拟环境中是否已经存在同名的环境变量,都会强行用 .env 文件里写的值去覆盖它
load_dotenv(override=True)

# 创建 DeepSeek LLM
# ChatDeepSeek 类会自动读取 .env 中的 DEEPSEEK_API_KEY 和 DEEPSEEK_API_BASE
# 其中 DEEPSEEK_API_BASE 会有一个默认值,如果我们在 .env 文件中定义的是 DEEPSEEK_BASE_URL 这时会取 DEEPSEEK_API_BASE 默认值。
deepseek = ChatDeepSeek(
    model_name = "deepseek-flash"
)

# 通过 invoke 像 LLM 提出问题
print(deepseek.invoke("请介绍一下你自己"))智普大模型
- 安装依赖
bash
# 安装 Langchain 社区依赖包,包含ChatHunyuan、ChatTongyi、ChatZhipuAI
pip install langchain-community

# ChatZhipuAI / 智谱 AI 认证相关依赖
pip install pyjwt千问大模型
- 安装依赖
bash
# ChatTongyi / 阿里通义千问依赖包
pip install dashscope兼容用法
- 使用 ChatOpenAI 实例对象可以整合多个平台的大模型实例方法
- 以 DeepSeek 为例
python
import os

from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

load_dotenv(verbose=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_API_BASE = os.getenv("DEEPSEEK_API_BASE")

openAI = ChatOpenAI(
    api_key = DEEPSEEK_API_KEY,
    base_url = DEEPSEEK_API_BASE,
    model = "deepseek-flash"
)

print(openAI.invoke("请介绍一下你自己"))中转平台
- 国内:CloseAI 官网
- 国外:OpenRouter 官网
- 中转平台大同小异,实现的目的和上面的一样,代码也差不多。
模型初始化-init_chat_model()
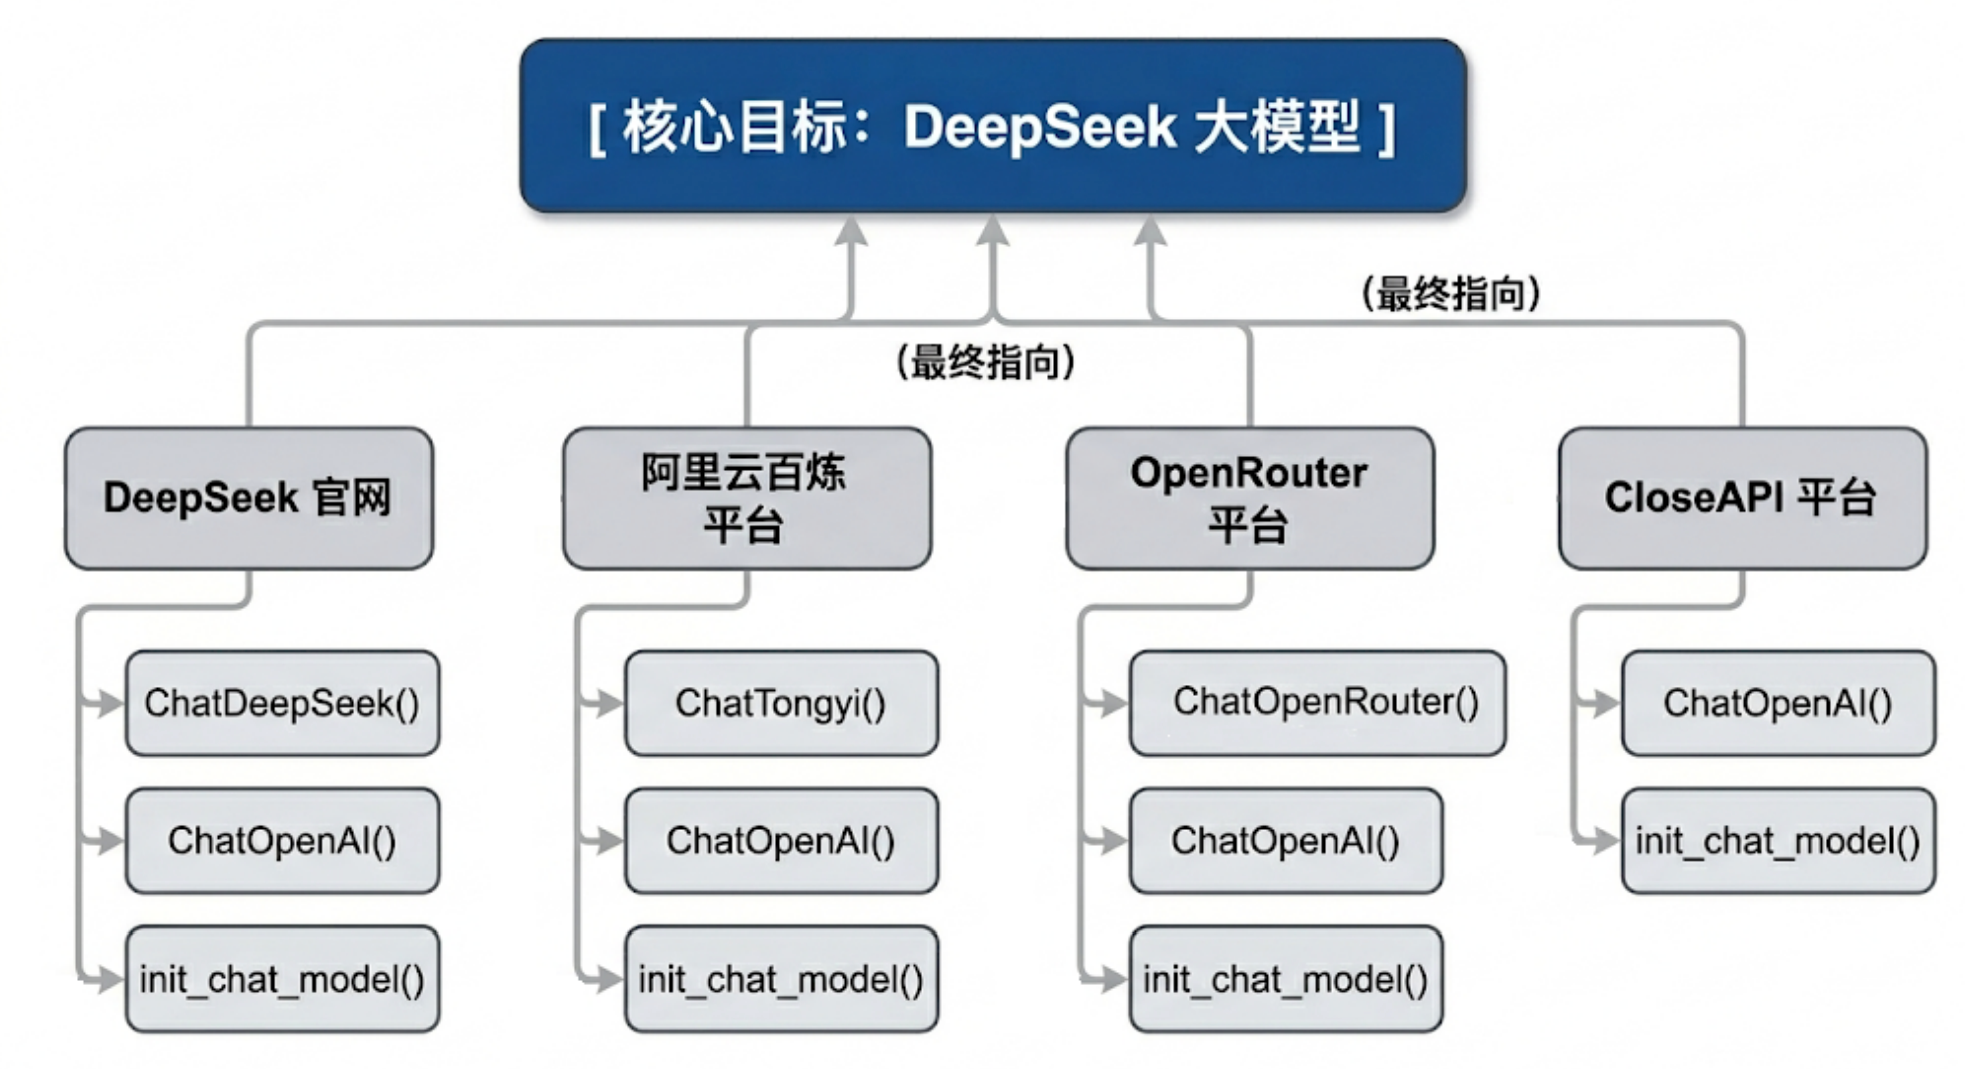
init_chat_model 是 LangChain 1.x 中推出的用于初始化聊天模型的统一接口。只要是LangChain支持 的模型都可以处理,它会根据模型名称自动选择对应的模型类初始化实例。
面试题:init_chat_model 和直接使用 ChatTongyi、ChatOpenAI、ChatDeepSeek有什么区别?
init_chat_model 的优势:
- 统一接口:无需记住每个提供商的不同初始化方式(以一致的方式初始化)
- 易于切换:简化了智能体系统中模型切换策略(只需修改模型字符串)
- 简洁明了:更简洁的语法,减少样板代码
- 自动适配:内部根据模型标识自动选择对应的驱动类(ChatOpenAI、ChatDeepSeek)
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(verbose=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_API_BASE = os.getenv("DEEPSEEK_API_BASE")

model = init_chat_model(
    model = "deepseek:deepseek-flash",
    api_key = DEEPSEEK_API_KEY,
    base_url = DEEPSEEK_API_BASE,
)

print(model.invoke('用一句话介绍你自己'))这里的 model 属性的格式是 供应商:模型名,也可以拆成 model_provider(供应商) + model(模型名)
关于供应商,有很多平台都支持某个大模型,一张图解释
模型初始化的常用参数
参数中文文档:https://docs.langchain.org.cn/oss/python/langchain/models#parameters
| 参数 | 类型 | 说明 | 默认值 |
|---|---|---|---|
| model | str | 特定供应商的模型名(必需) | 无 |
| model_provider | str | 模型供应商 | 无 |
| api_key | str | API 密钥 | None |
| base_url | str | 大模型 API 请求地址 | None |
| temperature | float | 控制输出随机性,范围0.0 - 2.0 | 0.7 |
| max_tokens | int | 限制模型输出的最大 token 数量 | None |
| timeout | float | 超时时间(秒) | None |
| max_retries | int | 请求失败是最大重试次数 | 6 |
temperature
- 0.0-0.3:需要一致性、准确性的任务(数学计算、数据提取、分类、代码生成)
- 0.5-0.7:平衡创造性和一致性(聊天、问答)
- 0.8-1.5:创造性任务(写作、头脑风暴)
- 1.5-2.0:高度创造性(诗歌、故事创作)
max_tokens
面试题:什么是 Token
基本单位:大模型通过分词器(Tokenizer)将文本拆分后的最小语义单元是 token(相当于自然语言中的词或字)。 不同的模型采用不同的分词算法 (如BPE、WordPiece),因此同一段文本在不同模型中 的Token数量可能不同。
收费依据:大语言模型通常也是以token的数量作为其计量(或收费)的依据。
1个中文Token≈1-1.8个汉字,1个英文Token≈3-4个字符
初始化本地 Ollama 模型时,需传入 num_predict 属性替代 max_tokens。
Token与字符转化的可视化工具:
- OpenAI 提供:https://platform.openai.com/tokenizer
- 百度智能云提供:https://console.bce.baidu.com/support/#/tokenizer
模型初始化-本地部署 Ollama
- GitHub:https://github.com/ollama/ollama
- Ollama 官网:https://ollama.com/
Ollama 常用指令
| 指令 | 说明 |
|---|---|
| ollama pull llama3 | 下载指定模型(例:llama3) |
| ollama run llama3 | 启动并进入该模型交互对话 |
| ollama list | 列出本机已下载的所有模型 |
| ollama rm llama3 | 删除不再需要的模型以节省磁盘 |
| ollama cp llama3 my-llama3 | 本地复制/重命名模型 |
| ollama show llama3 | 查看模型详细信息(参数、大小等) |
| ollama create my-model -f Modelfile | 用自定义 Modelfile 构建新模型 |
| ollama serve | 启动后台服务,供 API 调用 |
| ollama ps | 查看当前正在运行的模型进程 |
| ollama stop llama3 | 停止正在运行的模型 |
| ollama --version | 查看安装的ollama版本 |
调用 Ollama
python
from langchain_ollama import ChatOllama

model = ChatOllama(
    model = "deepseek-coder:latest"
)

print(model.invoke("介绍一下 Vue2 和 Vue3 的区别"))python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

print(model.invoke("介绍一下 Vue2 和 Vue3 的区别"))- 在调用本地 Ollama 时,不需要指定
api_key和base_url,如果非要指定base_url值可以设定为http://localhost:11434,11434是启动 Ollama 默认的端口号。 - 通过
init_chat_model方式创建对象时,需要指定供应商ollama:xxx,否则会报错。
模型的调用
在 LangChain 中,模型调用是指通过特定方法触发大语言模型生成输出的过程。 根据不同的应用场景和需求,LangChain 提供了几种核心的调用方式,主要是 invoke() 、 stream() 和 batch() 方法,以及它们的异步版本 ainvoke() 、 astream() 和 abatch() 。
invoke():阻塞式,一次性返回完整结果问答、批处理任务、无需实时反馈的场景。ainvoke():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。stream():流式输出,实时返回每个token聊天机器人、长文本生成、需要提升用户体验的交互应用。astream():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。batch():批量处理多个输入高并发场景,需要同时处理大量请求。abatch():非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
invoke()
invoke() 是 LangChain 中最核心的方法,它的工作模式是阻塞式的,即程序会等待模型完全生成整个响应后,再一次性将结果返回给用户。
说明
简单来说,invoke 方法的作用就是:
- 接收你的输入(问题、指令、对话历史等)
- 发送给 LLM 模型(如 GPT-4、Llama、Claude 等)
- 返回模型的响应(文本回复 + 元数据信息)
基本语法
python
res = model.invoke(input, config = None)参数说明
| 参数 | 类型 | 说明 | 必需 | 默认值 |
|---|---|---|---|---|
| input | str|list[dict]|list[Message] | 你要发送给模型的内容 | 必需 | 无 |
| config | dict | 高级配置(回调函数、元数据、标签等) | 可选 | None |
入参-文本类型
- 简单的一次性问答,直接传入一个问题或指令。
- 适用场景:快速测试,不需要保留对话历史的简单生成任务。
- 缺点:无法设置系统提示,无法传递对话历史。
入参-字典列表
- 创建字典列表组成消息。一条消息通常包含
role(角色)、content(内容)等信息。 - 适用场景:可以设置系统提示,表达多轮对话历史,JSON 兼容,易于序列化和网络传输,生产环境推荐。
- 缺点:代码稍微多一点(但更清晰)
- 格式:
python
messages = [
   {"role": "system", "content": "系统提示"},
   {"role": "user", "content": "用户消息"},
   {"role": "assistant", "content": "AI回复"}, # 可选,用于对话历史
   {"role": "user", "content": "继续提问"}
]- 角色说明:
| 角色 | 英文 | 作用 | 示例 |
|---|---|---|---|
| system | System | 设定 AI 的行为、角色、规则 | "你是一个专业的 Python 导师" |
| user | Human / User | 用户的输入/问题 | "什么是装饰器?" |
| assistant | AI / Assistant | AI 的历史回复(用于对话上下文) | "装饰器是一种设计模式..." |
python
from langchain.chat_models import init_chat_model

message = [
    {"role": "system", "content": "你是一个非常优秀的前端老师"},
    {"role": "user", "content": "请问什么是防抖"},
]

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

print(model.invoke(message).content)python
from langchain.chat_models import init_chat_model

message = [
    {"role": "system", "content": "你是一个非常优秀的前端老师"},
    {"role": "user", "content": "请问什么是防抖"},
]

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

res = model.invoke(message).content
print(f"第一次回复:{res}")

message.append({"role": "assistant", "content": res})
message.append({"role": "user", "content": "上一个问题的题干是什么?"})
res = model.invoke(message).content
print(f"第二次回复:{res}")入参-消息对象列表
- 使用内置的消息类(如 SystemMessage, HumanMessage, AIMessage),将消息对象列表输入模型。
- 适用场景:需要类型检查(针对大型项目)、IDE 自动补全的场景
- 缺点:代码较长、不如字典简洁、难以序列化(JSON)
- 消息类型对照:
| 消息类 | 对应字典格式 | 作用 |
|---|---|---|
| SystemMessage | {"role": "system", ...} | 系统提示 |
| HumanMessage | {"role": "user", ...} | 用户输入 |
| AIMessage | {"role": "assistant", ...} | AI 回复 |
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage

message = [
    # {"role": "system", "content": "你是一个非常优秀的前端老师"},
    # {"role": "user", "content": "请问什么是防抖"},
    SystemMessage("你是一个非常优秀的前端老师"),
    HumanMessage("请问什么是防抖")
]

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

print(model.invoke(message).content)返回值
nvoke 返回一个 AIMessage 对象
python
AIMessage(
    # --- 核心内容 ---
    content = '2 + 3 * 2 = **8**', # 模型生成的最终文本答案
    additional_kwargs = {
        'refusal': None  # 模型拒绝回答的情况(如触碰安全策略),None 表示正常回答
    },

    # --- 响应元数据(API 返回的详细原始数据) ---
    response_metadata = {
        'token_usage': {
            'completion_tokens': 15,  # 生成回答消耗的 Token 数(输出)
            'prompt_tokens': 16,  # 用户输入消耗的 Token 数(输入)
            'total_tokens': 31,  # 本次交互总共消耗的 Token
            'completion_tokens_details': {
                'accepted_prediction_tokens': 0,  # 预测性生成的 Token 数
                'audio_tokens': 0,  # 音频生成消耗(如有)
                'reasoning_tokens': 0,  # 推理模型(如 o1)思考过程消耗的 Token
                'rejected_prediction_tokens': 0  # 被拒绝的预测 Token
            },
            'prompt_tokens_details': {
                'audio_tokens': 0,  # 输入中的音频 Token 数
                'cached_tokens': 0  # 命中的缓存 Token 数(能省钱/提速)
            },

            # --- 延迟性能监控(单位:毫秒 ms) ---
            'latency_checkpoint': {
                'engine_tbt_ms': 4,  # 引擎 Token 间平均间隔时间
                'engine_ttft_ms': 36,  # 引擎生成首个 Token 的时间
                'engine_ttlt_ms': 100,  # 引擎生成最后一个 Token 的时间
                'pre_inference_ms': 86,  # 推理前的预处理耗时(安全审核、Token 化等预处理)
                'service_tbt_ms': 4,  # 服务端token与token之间生成的间隔时间,决定了打字机效果是否丝滑。
                'service_ttft_ms': 280,  # 服务端接收到请求到输出首字的总时间
                'service_ttlt_ms': 338,  # 服务端完成全部输出的总时间
                'total_duration_ms': 259,  # 本次请求在系统中记录的总持续时长
                'user_visible_ttft_ms': 194  # 用户看到第一个字跳出来等待的时间
            }
        },
        'model_provider': 'openai',  # 模型供应商
        'model_name': 'gpt-5.4-mini-2026-03-17',  # 使用的具体模型版本
        'system_fingerprint': None,  # 系统指纹,用于追踪模型后端的配置变更
        'id': 'chatcmpl-DgWobsxhDOqzjqVFwbZYKRnovpEiV',  # API层面的响应 ID
        'service_tier': 'default',  # 服务层级(如按量付费或订阅)
        'finish_reason': 'stop',  # 停止原因:stop(自然结束)、length(长度受限)
        'logprobs': None  # 对数概率(通常用于分析词汇选择的可能性)
    },

    # --- LangChain 内部标识 ---
    id = 'lc_run--019e3659-5ee2-7b62-bc8a-741e27374b43-0',
    # LangChain 追踪此条运行的唯一 ID

    # --- 工具调用信息 ---
    tool_calls = [],  # 正常触发的外部工具调用列表
    invalid_tool_calls = [],  # 触发失败或格式错误的工具调用

    # --- 统一消耗元数据(LangChain 标准化后的消耗格式) ---
    usage_metadata = {
        'input_tokens': 16,  # 输入 Token 数
        'output_tokens': 15,  # 输出 Token 数
        'total_tokens': 31,  # 总 Token 数
        'input_token_details': {
            'audio': 0,
            'cache_read': 0  # 从缓存中读取的输入数量
        },
        'output_token_details': {
            'audio': 0,
            'reasoning': 0  # 包含在输出中的推理 Token
        }
    }
)stream()
流式调用,实时返回响应片段。调用后,返回一个迭代器(iterator),可以通过循环来实时处理每一个新生成的chunk内容块。
python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

for res in model.stream("帮我解释一下什么是防抖"):
print(res.text, end = "", flush = True)batch()
batch() 方法允许你一次性 发送一组请求 (含多条独立请求),模型会在后台 并行处理 ,然后返回所有结果的列表。
与逐个顺序调用(invoke)相比,能大幅减少网络往返开销和等待时间 ,显著提升性能、降低成本。
batch_as_completed() 允许应用在收到第一个结果后立即返回响应,而不会等待批次内所有任务完成才响应。
python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

message = model.batch([
    "什么是防抖",
    "Vue2 和 Vue3 的区别",
    "JS 和 TS 的区别"
])
for res in message:
print(res.content, end="\n\n")python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = "ollama:deepseek-coder:latest"
)

message = model.batch_as_completed([
    "什么是防抖",
    "Vue2 和 Vue3 的区别",
    "JS 和 TS 的区别"
])
for res in message:
print(res, end="\n\n")拓展知识
美化输出
python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = 'ollama:deepseek-coder:latest'
)

res = model.invoke("介绍一下 Vue3")
res.pretty_print()python
from langchain.chat_models import init_chat_model
from rich import print as rprint

model = init_chat_model(
    model = 'ollama:deepseek-coder:latest'
)

res = model.invoke("介绍一下 Vue3")
rprint(res)模型配置信息 profile
- LangChain1.1及更高版本可以通过
profile属性查看模型的配置信息. - 这是LangChain针对模型的能力画像,但是否存在,取决于LangChain在集成模型厂商的服务时是否声明了能力画像
python
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model = 'ollama:deepseek-coder:latest'
)
print(model.profile)模型调用中的 config 参数
- 在调用模型时(如使用 invoke(), ainvoke(), stream(),batch()等方法时),我们可以传入 config 参数。
- config 参数允许在调用模型时,动态地配置和控制模型的行为,而无需在初始化时就固定所有参数,这为应用带来了极大的灵活性和可维护性。
- config 中支持配置的参数如下:
| 配置项 | 类型 | 描述 |
|---|---|---|
| run_name | str | 为当前运行设置一个可读的名称。如在 LangSmith 追踪系统中快速定位和识别不同的运行任务。 |
| tags | List[str] | 为运行设置标签,用于分类和过滤。如在 LangSmith 追踪系统中快速定位和识别不同的运行任务。 |
| callbacks | List[BaseCallbackHandler] | 设置回调处理器,在运行的不同阶段(开始、流输出、结束等)触发。与一些监控平台(如 LangSmith)集成进行深度追踪和调试。 |
| metadata | Dict[str,Any] | 附加任意的键值对元数据。记录本次调用的业务上下文,如{"user_id": "123", "session_id":"abc"} |
| max_concurrency | int | 限制当前可运行对象的最大并发运行数。防止对API接口或本地资源造成过大压力,实现简单的速率限制。 |
| recursion_limit | int | 限制运行时递归调用的最大深度。主要在复杂的工作流(如Agent执行多步工具调用)中,防止出现无限递归循环。 |
| configurable | Dict[Str,Any] | 一个万能字典,用于传递其他可配置参数。实现更高级的动态行为,如配置可替代的模型或组件。 |
- config中参数
run_name、tags、callbacks主要用在LangSmith中,用于追踪、筛选和调试。 metadata可以配置用户指定的一些信息,在工作流开发中,当整个流程被包装为Runnable链时,可以将这些参数传递给后续的链节点使用。configurable中可配置的参数与init_chat_model初始化模型参数一样,与在初始化模型时设置的参数(如 temperature=0.7)的关键区别在于:init_chat_model初始化参数:模型的默认设置,适用于该模型实例的大部分场景。- 运行时 config:单次调用的特定设置,优先级更高,针对本次调用进行的特殊调整。