搜索文档
结构化输出概述
LangChain的结构化输出(Structured Output) 指的是:它的核心目标是把 自然语言回答 变成 程序可以稳定消费的数据。
这样做的价值主要有三点:
- 更容易被代码处理:下游系统可以直接读字段,而不是再从自然语言里做解析。
- 结果更稳定:减少“模型说法变了但意思差不多”导致的解析失败。
- 更适合工程化:适用于表单抽取、分类、路由、调用工具参数生成、工作流状态传递等场景。
传统方式
python
# 1. 提示词要求JSON
prompt = "以JSON格式返回:{name, age, occupation}"
response = model.invoke(prompt)

# 2. 手动解析
import json
data = json.loads(response.content)

# 3. 手动验证类型
if not isinstance(data['age'], int):
    raise ValueError("age must be int")

# 4. 手动创建对象
person = Person(**data)结构化输出
目前LangChain 1.x 支持多种Schema与结构化输出方式:
- Pydantic(字段校验、描述、嵌套结构,功能最丰富)
- TypedDict(轻量类型约束)
- JSON Schema(与前后端/跨语言接口最通用)
- dataclass
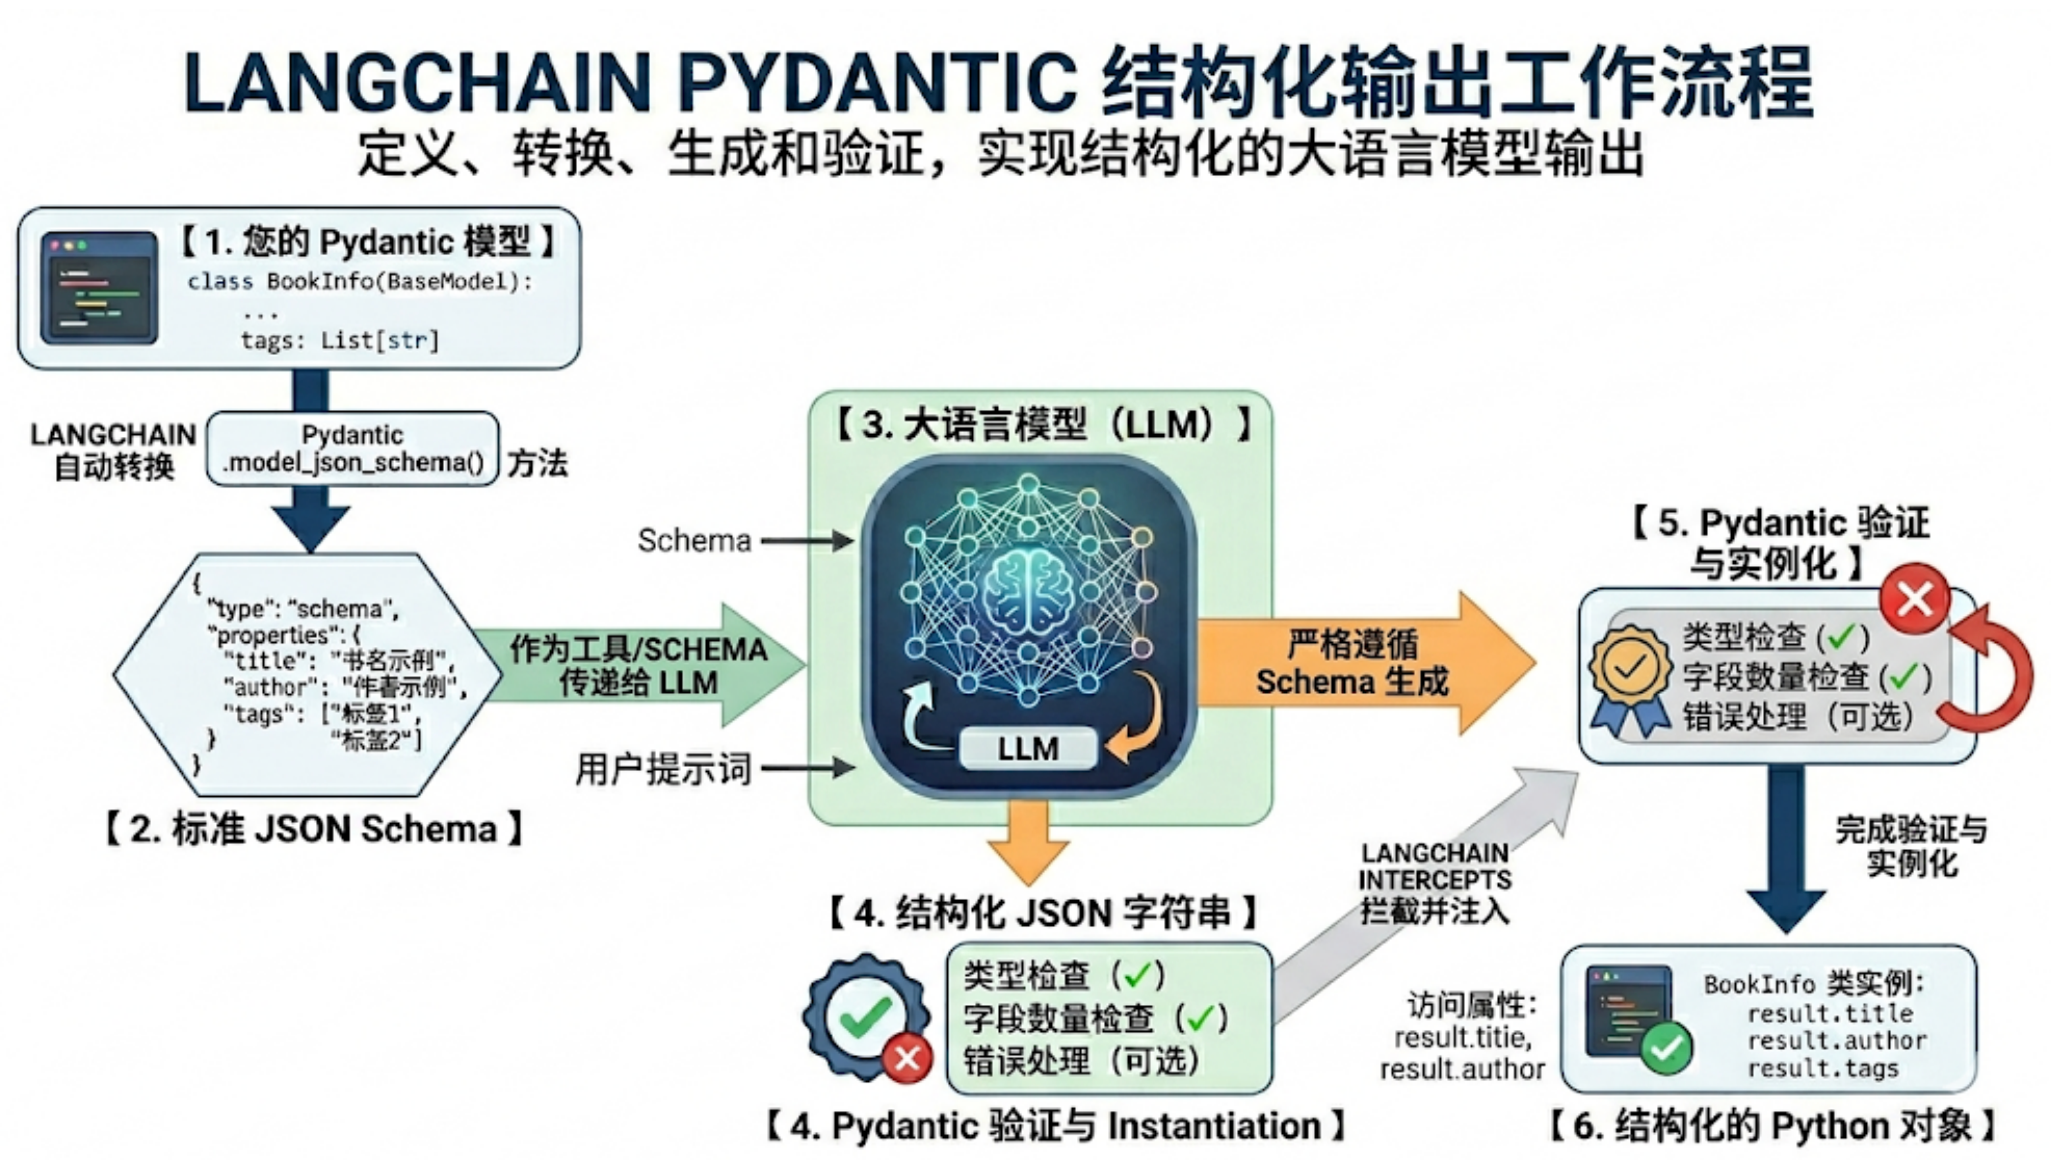
模型对象可以调用 with_structured_output() 绑定输出模式(schema)。
只有 Pydantic 返回的是Schema类实例,其余三种方式返回的都是字典 ;也只有 Pydantic 在类型不匹配时会抛出异常。
Pydantic 模式
它通过在运行时强制执行类型提示,确保数据的正确性和一致性,是 生产场景首选 。
基本使用
需要满足的几个要素:
- 所有结构化输出的数据模型都必须继承 BaseModel。
- 使用类型提示。Pydantic 支持丰富的字段类型:str 、int、float、List[xxx]、Optional[xxx]等。
- 使用 Field() 添加字段默认值和描述,帮助 LLM 理解字段含义
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class movie_info(BaseModel):
    title: str = Field(description="电影标题")
    time: str = Field(description="发布时间")
    direct: str = Field(description="导演")
    leading_role: list[str] = Field(description="主演")
    mark: float = Field(description="评分")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(movie_info)

res = model.invoke("帮我整理一份电影《夏洛特烦恼》的信息")
print(res)
print(type(res))
print(f"电影《{res.title}》发布于{res.time},导演:{res.direct}。主演:{res.leading_role}。评分:{res.mark}")

""" 输出结果:
title='夏洛特烦恼' time='2015-09-30' direct='闫非、彭大魔' leading_role=['沈腾', '马丽', '尹正', '艾伦', '王智'] mark=7.6
<class '__main__.movie_info'>
电影《夏洛特烦恼》发布于2015-09-30,导演:闫非、彭大魔。主演:['沈腾', '马丽', '尹正', '艾伦', '王智']。评分:7.6
"""可选字段
使用 Optional 指定字段为可选的。
python
import os

from typing import Optional
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class user_info(BaseModel):
    name: str = Field(description="姓名")
    age: Optional[int] = Field(description="年龄")
    state: str = Field(description="工作状态")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(user_info)

res = model.invoke("张三同学目前在一家互联网公司入职,按格式输出张三的信息")
print(res)

""" 输出结果:
name='张三' age=None state='已入职互联网公司'
"""默认值
使用 Field 的 default 指定默认值,各供应商有差异,不是所有的都支持。
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class user_info(BaseModel):
    name: str = Field(description="姓名")
    age: int = Field(description="年龄", default=20)
    state: str = Field(description="工作状态")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(user_info)

res = model.invoke("张三同学目前在一家互联网公司入职,按格式输出张三的信息")
print(res)

""" 输出结果:
name='张三' age=20 state='已入职(互联网公司)'
"""枚举类型
枚举类型有两种实现方式,定义枚举和 Literal。
python
import os

from enum import Enum
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class Status(str, Enum):
    T = "在职"
    F = "离职"

class user_info(BaseModel):
    name: str = Field(description="姓名")
    age: int = Field(description="年龄", default=20)
    state: Status = Field(description="工作状态")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(user_info)

res = model.invoke("张三同学目前在一家互联网公司入职,按格式输出张三的信息")
print(res)

""" 输出结果:
name='张三' age=20 state=<Status.T: '在职'>
"""python
import os

from typing import Literal
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class user_info(BaseModel):
    name: str = Field(description="姓名")
    age: int = Field(description="年龄", default=20)
    state: Literal["在职", "离职"] = Field(description="工作状态")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(user_info)

res = model.invoke("张三同学目前在一家互联网公司入职,按格式输出张三的信息")
print(res)

""" 输出结果:
name='张三' age=20 state='在职'
"""列表提取
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field
from typing import List

load_dotenv(verbose=True)

class UserInfo(BaseModel):
    name: str = Field(description="姓名")
    role: str = Field(description="扮演的角色")

class UserList(BaseModel):
    users: List[UserInfo]

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(UserList)

res = model.invoke("查一下《夏洛特烦恼》演员列表")
print(res)

""" 输出结果:
users=[UserInfo(name='沈腾', role='夏洛'), UserInfo(name='马丽', role='马冬梅'), UserInfo(name='尹正', role='袁华'), UserInfo(name='王智', role='秋雅'), UserInfo(name='艾伦', role='张扬'), UserInfo(name='常远', role='孟特娇')]
"""嵌套结构
python
import os

from typing import List
from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field

load_dotenv(verbose=True)

class UserInfo(BaseModel):
    """演员信息"""
    name: str = Field(description="姓名")
    role: str = Field(description="扮演的角色")

class MovieInfo(BaseModel):
    """电影信息"""
    title: str = Field(description="电影标题")
    time: str = Field(description="发布时间")
    direct: str = Field(description="导演")
    users: List[UserInfo] = Field(description="演员列表")
    mark: float = Field(description="评分")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(MovieInfo)

res = model.invoke("查一下《夏洛特烦恼》信息")
print(res)

""" 输出结果:
title='夏洛特烦恼' time='2015-09-30' direct='闫非、彭大魔' users=[UserInfo(name='沈腾', role='夏洛'), UserInfo(name='马丽', role='马冬梅'), UserInfo(name='尹正', role='袁华'), UserInfo(name='艾伦', role='大春'), UserInfo(name='王智', role='秋雅')] mark=7.8
"""条件限定
注:不同平台表现方式不同
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import BaseModel, Field
from typing import List

load_dotenv(verbose=True)

class UserInfo(BaseModel):
    name: str = Field(description="姓名")
    role: str = Field(description="扮演的角色")
    age: int = Field(description="年龄", ge=40) # gt-大于 ge-大于等于 lt-小于 le-小于等于

class UserList(BaseModel):
    users: List[UserInfo]

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(UserList)

res = model.invoke("查一下《夏洛特烦恼》三个演员")
print(res)

""" 输出结果:
users=[UserInfo(name='沈腾', role='夏洛', age=45), UserInfo(name='马丽', role='马冬梅', age=42), UserInfo(name='尹正', role='袁华', age=40)]
"""工作流程图解
TypedDict 模式
TypedDict 是 Python 3.8+ 引入的一种类型提示工具,即带有类型声明的字典结构。适合需要快速定义字典结构且无需 Pydantic 重量级功能的场景。
Annotated 用来在“类型”之外,再附加一些额外信息,即元数据。类似于 Pydantic 的 Field 。
基本用法
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from typing import List
from typing_extensions import Annotated, TypedDict

load_dotenv(verbose=True)

class UserInfo(TypedDict):
    """演员信息"""
    name: Annotated[str, "姓名"]
    role: Annotated[str, "扮演的角色"]
    age: Annotated[int, "年龄"]

class MovieInfo(TypedDict):
    """电影信息"""
    title: Annotated[str, "电影名"]
    time: Annotated[str, "上映时间"]
    direct: Annotated[str, "导演"]
    users: Annotated[List[UserInfo], "演员列表"]
    mark: Annotated[float, "评分"]

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(MovieInfo)

res = model.invoke("介绍一下《夏洛特烦恼》这部电影")
print(res)

""" 输出结果:
{'title': '夏洛特烦恼', 'time': '2015-09-30', 'direct': '闫非、彭大魔', 'mark': 7.6, 'users': [{'name': '沈腾', 'role': '夏洛', 'age': 36}, {'name': '马丽', 'role': '马冬梅', 'age': 33}, {'name': '尹正', 'role': '袁华', 'age': 29}, {'name': '艾伦', 'role': '张扬', 'age': 32}, {'name': '王智', 'role': '秋雅', 'age': 31}]}
"""... 的使用
与模型供应商有关,部分供应商的大模型不支持。
上述代码的 ... 是Python的字面量,等价于 Ellipsis ,可以理解为占位符。下游框架(如 LangChain)可以对 ... 作定制化处理,如 LangChain 中 Annotated 的 ... 表示当前字段是必须存在的,不可省略,用来指示模型的输出。
使用格式如下:
python
class MovieInfo(TypedDict):
    """电影信息"""
title: Annotated[str, ..., "电影名"]JSON Schema 模式
这种方式需要按照JSON Schema规范拼接JSON字符串,比较繁琐,并且缺少校验机制。不推荐。
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(verbose=True)

movieInfoJson = {
    "title": "Movie",
    "description": "电影信息",
    "type": "object",
    "properties": {
        "title": {"type": "string", "description": "电影名"},
        "time": {"type": "string", "description": "上映时间"},
        "direct": {"type": "string", "description": "导演"},
    },
    "required": ["title", "time", "direct"]
}

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(movieInfoJson, method="json_schema")

res = model.invoke("介绍一下《夏洛特烦恼》这部电影")
print(res)

""" 输出结果:
{'title': '夏洛特烦恼', 'time': '2015年9月30日', 'direct': '闫非、彭大魔'}
"""@dataclass 模式
@dataclass是 Python 标准库 dataclasses 提供的类装饰器,用于简化“以字段为核心”的数据类定义。
给类加上 @dataclass 后,Python 会根据字段声明自动生成常用方法,例如:
__init____repr____eq__
虽然 @dataclass 在行为上接近于手写 __init__ 、 __repr__ 、 __eq__ 的普通类,但二者并不完全等价。
python
import os
from dataclasses import dataclass

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import Field

load_dotenv(verbose=True)

@dataclass
class MovieInfo:
    """电影信息"""
    title: str = Field(description="电影标题")
    time: str = Field(description="上映时间")
    direct: str = Field(description="导演")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(MovieInfo)

res = model.invoke("介绍一下《夏洛特烦恼》这部电影")
print(res)

""" 输出结果:
{'title': '夏洛特烦恼', 'time': '2015', 'direct': '闫非、彭大魔'}
"""四种模式的校验
- Pydantic 返回值类型是 with_structured_output 传入类的实例对象,所以当我们设定类属性为
title但大模型返回的是title1这时候会报错。 - 其他三种方式返回值都是
dict所以不会报错。
关于 with_structured_output
这种方式是最新、最简洁的 API,直接让模型“理解”你需要的数据结构,并返回解析好的对象。
此外,我们可以在 with_structured_output 方法中传入 include_raw=True 参数,表示返回解析前的原始 AIMessage,从而访问令牌用量等元数据。
python
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from pydantic import Field, BaseModel
from rich import print as rprint

load_dotenv(verbose=True)

class MovieInfo(BaseModel):
    """电影信息"""
    title: str = Field(description="电影标题")
    time: str = Field(description="上映时间")
    direct: str = Field(description="导演")

model = init_chat_model(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url=os.getenv("DEEPSEEK_API_BASE")
).with_structured_output(MovieInfo, include_raw=True)

res = model.invoke("介绍一下《夏洛特烦恼》这部电影")
rprint(res)

""" 输出结果:
{
    'raw': AIMessage(
        content='',
        additional_kwargs={'refusal': None},
        response_metadata={
            'token_usage': {
                'completion_tokens': 77,
                'prompt_tokens': 317,
                'total_tokens': 394,
                'completion_tokens_details': None,
                'prompt_tokens_details': {
                    'audio_tokens': None,
                    'cached_tokens': 128
                },
                'prompt_cache_hit_tokens': 128,
                'prompt_cache_miss_tokens': 189
            },
            'model_provider': 'deepseek',
            'model_name': 'deepseek-flash',
            'system_fingerprint': 'e72d3c7f663d3e1383b00b3884cb4501',
            'id': 'd0ad633d-71ff-4f9c-ad4d-e07c2bdf44e1',
            'finish_reason': 'tool_calls',
            'logprobs': None
        },
        id='lc_run--01a17894-3f35-7115-8abe-235a32ece9f7-0',
        tool_calls=[
            {
                'name': 'MovieInfo',
                'args': {
                    'title': '夏洛特烦恼',
                    'time': '2015-09-30',
                    'direct': '闫非、彭大魔'
                },
                'id': 'call_00_LNNVAraiMrta6QxTeLc78670',
                'type': 'tool_call'
            }
        ],
        invalid_tool_calls=[],
        usage_metadata={
            'input_tokens': 317,
            'output_tokens': 77,
            'total_tokens': 394,
            'input_token_details': {'cache_read': 128},
            'output_token_details': {}
        }
    ),
    'parsed': MovieInfo(
        title='夏洛特烦恼',
        time='2015-09-30',
        direct='闫非、彭大魔'
    ),
    'parsing_error': None
}
"""